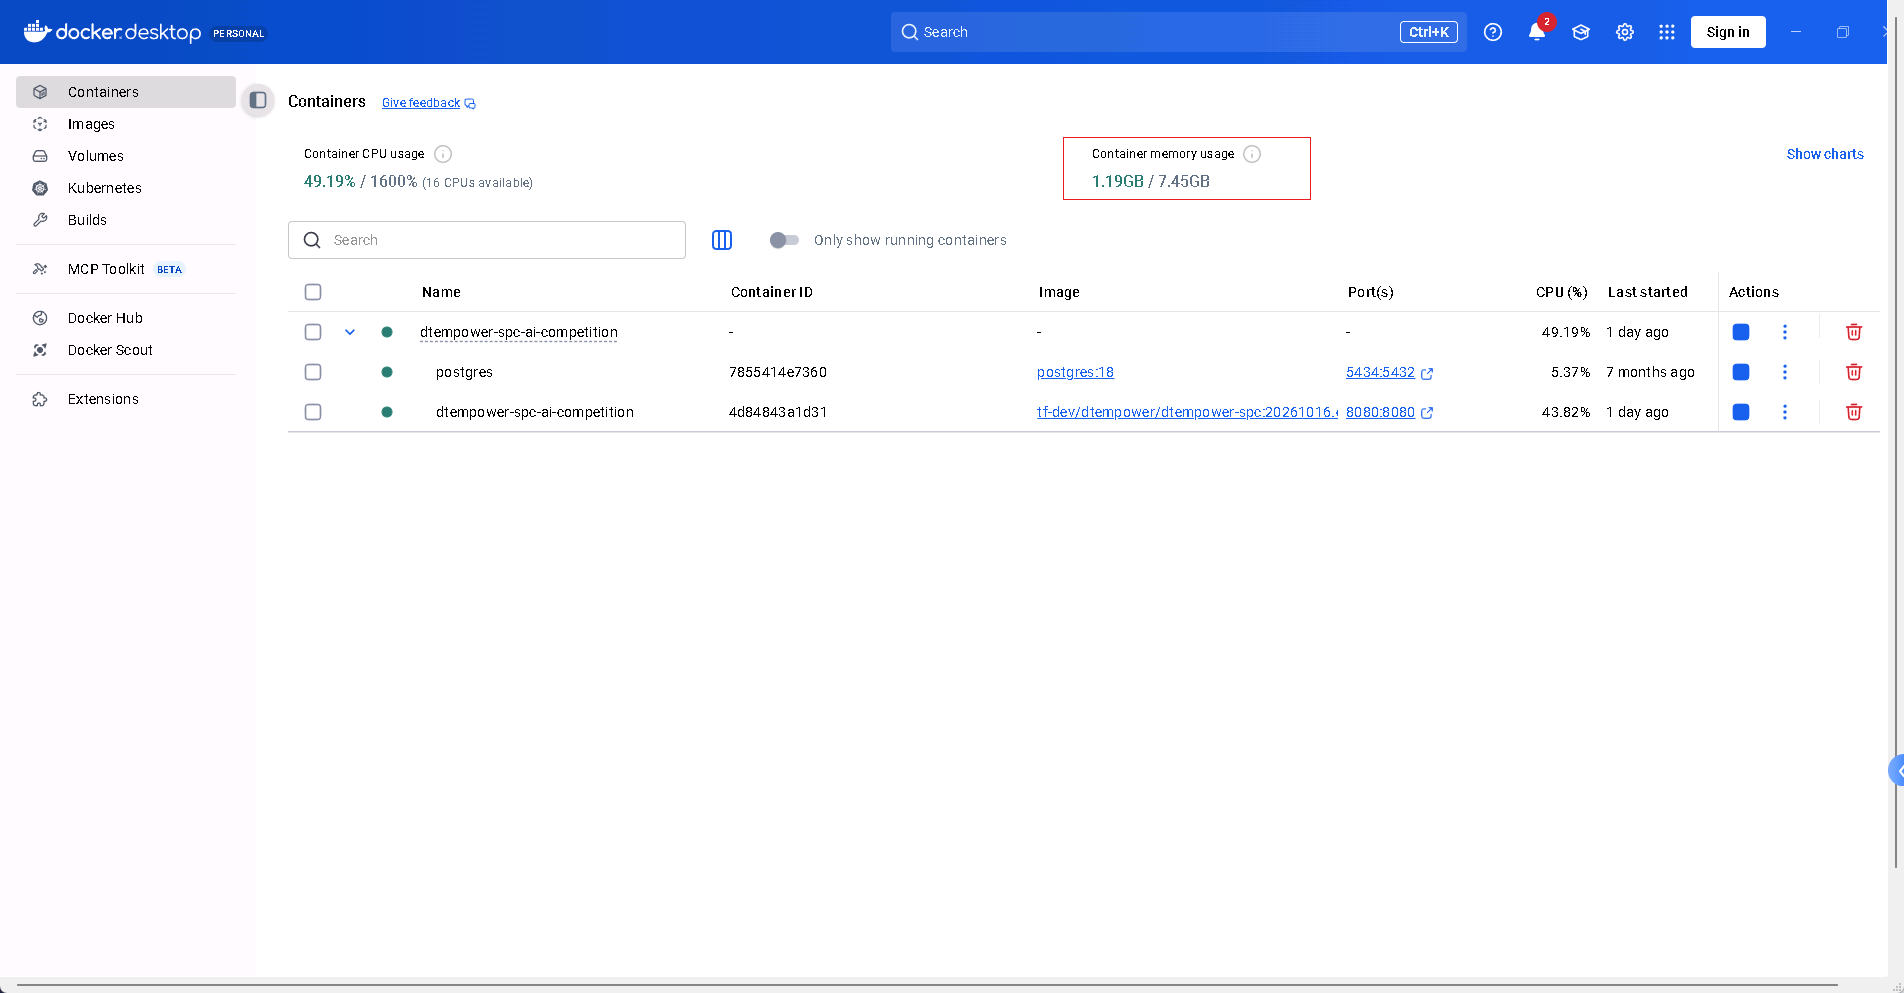
服务部署在 Docker 中,启动后出现 Java heap space,重启仍会复现。但服务器任务管理器显示还有约 6 GB 空闲内存,本地与服务器同样是 16 GB 内存,本地运行却正常。
通过 Eclipse Memory Analyzer(MAT)分析堆转储后,发现一个调度线程持有约 99% 的堆内存。沿线程栈查到业务代码,原因是:领取任务时只需要 ID,查询却返回了所有候选任务的完整数据快照。
下面记录排查过程。截图保留原貌,补充命令供复用,不代表现场全部执行过。命令使用 PowerShell 语法,先把容器名替换为自己的服务:
$container = "your-java-container"
1. 先确定报的是哪一种 OOM
最初日志同时出现 PostgreSQL 通信异常、事务回滚失败和 Tomcat 异步超时处理异常,看起来像多个模块一起出了问题。
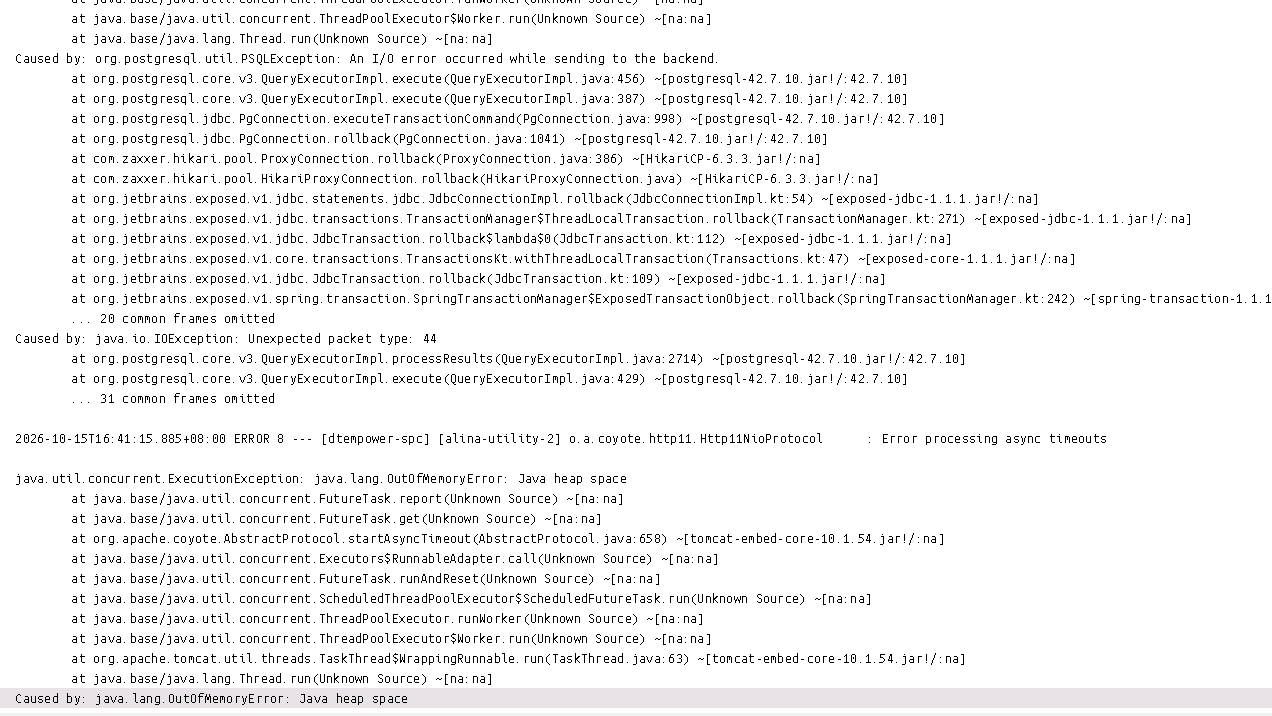
其中最关键的信息是:
java.lang.OutOfMemoryError: Java heap space
它说明 Java 堆无法分配新对象。先查堆内存不足的原因;数据库通信和回滚错误也可能是内存不足后的连带异常。
同时保留容器日志和退出状态,区分 Java 自己报错与进程被系统终止:
docker logs --timestamps --tail 500 $container
docker inspect --format '{{json .State}}' $container
结合 OOMKilled 和日志判断,不能只凭退出码 137 认定内存不足。本次日志明确报了 Java 堆内存不足。
2. 宿主机还有内存,为什么 Java 会内存不足
当时执行了三个检查:
docker stats --no-stream $container
docker inspect --format '{{.HostConfig.Memory}}' $container
docker exec $container printenv JAVA_OPTS
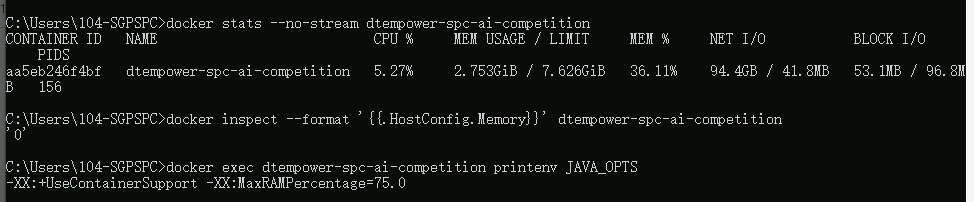
结果分别是:
服务器有 16 GB 内存,Docker 环境只报告约 7.6 GiB 可用,JVM 又从中分配堆内存。因此,Windows 还有空闲内存,Java 堆仍可能达到上限。
按截图粗算,最大堆约为 7.626 GiB × 75% ≈ 5.72 GiB,实际值以运行中的 JVM 为准。Java 进程还需要堆之外的内存,不能把 Docker 的全部额度都留给堆。参数说明
如果容器包含 JDK 诊断工具,可以检查实际应用进程:
docker exec $container jcmd -l
从结果中找到应用的 Java PID,再执行,以下 123 仅为示例:
docker exec $container jcmd 123 VM.flags
docker exec $container jcmd 123 GC.heap_info
查看 MaxHeapSize 和当前堆用量。精简镜像可能没有 jcmd;Java PID 也不一定是 1。另起 java -XX:+PrintFlagsFinal 查到的是新进程参数,应以实际应用进程为准。jcmd 文档
截图中的 2.753 GiB 是采样值,不能代表故障瞬间的峰值。Docker stats 各列含义
本地与服务器还要比较 JVM 参数、数据量、任务积压和并发情况。物理内存相同,不代表运行条件相同。
3. 重启无效,先保留堆转储
重启释放了进程内存,但数据库里的任务还在。调度器再次查询同一批大快照,问题就会重现。
此时需要分析故障现场的 .hprof 文件,也就是堆转储。它记录当时有哪些对象、被谁引用。
如果尚未启用自动转储,可以在 JVM 启动参数中追加:
-XX:+HeapDumpOnOutOfMemoryError
-XX:HeapDumpPath=/app/data/heapdumps
启用后,发生 Java OOM 才会自动生成文件,正常启动不会生成;也可以用诊断工具手动导出。容器被系统直接杀掉时,JVM 可能来不及转储。
目录要提前创建、确保可写并预留磁盘空间。启动参数修改后需重启应用,无法补回之前的现场。转储参数说明
/app/data 在 Windows 的哪个位置
/app/data 是容器内路径,先查看挂载关系:
docker inspect --format '{{json .Mounts}}' $container
现场使用 Docker 命名卷挂载 /app/data,它不直接对应 Windows 普通目录。无论采用哪种挂载方式,都可以通过 Docker 复制:
docker exec $container ls -lh /app/data
docker exec $container ls -lh /app/data/heapdumps
New-Item -ItemType Directory -Force -Path D:\oom-investigation
docker cp ${container}:/app/data/heapdumps/java_pid123.hprof D:\oom-investigation\server-oom.hprof
替换成实际文件路径,并核对修改时间,避免分析旧故障。docker cp 支持从已停止的容器复制文件,本地父目录需要提前创建。命令说明
5 GB 文件是不是超过了 Docker 的限制
5 GB 文件占用的是磁盘。Docker 的 7.626 GiB 是内存上限,Java 堆还有单独的上限,三者不能直接比较。
分析服务器故障,应使用服务器当时的文件。本地文件即使大小相同,对象和调用栈也可能不同。
删除文件只释放磁盘,不能解决 OOM。清理前保存现场;转储目标文件重名也可能导致新文件写入失败。
4. 用 MAT 找到“谁把内存留住了”
用免费的 Eclipse MAT 离线打开服务器的 .hprof。内网提前准备 MAT 及其要求的 Java 运行时,装在分析电脑上即可,无需为 Docker 服务在宿主机另装 Java。
打开后生成 Leak Suspects 报告。分析大文件时,可能需要调大 MAT 的 MemoryAnalyzer.ini 中的 -Xmx,并为索引预留磁盘空间。
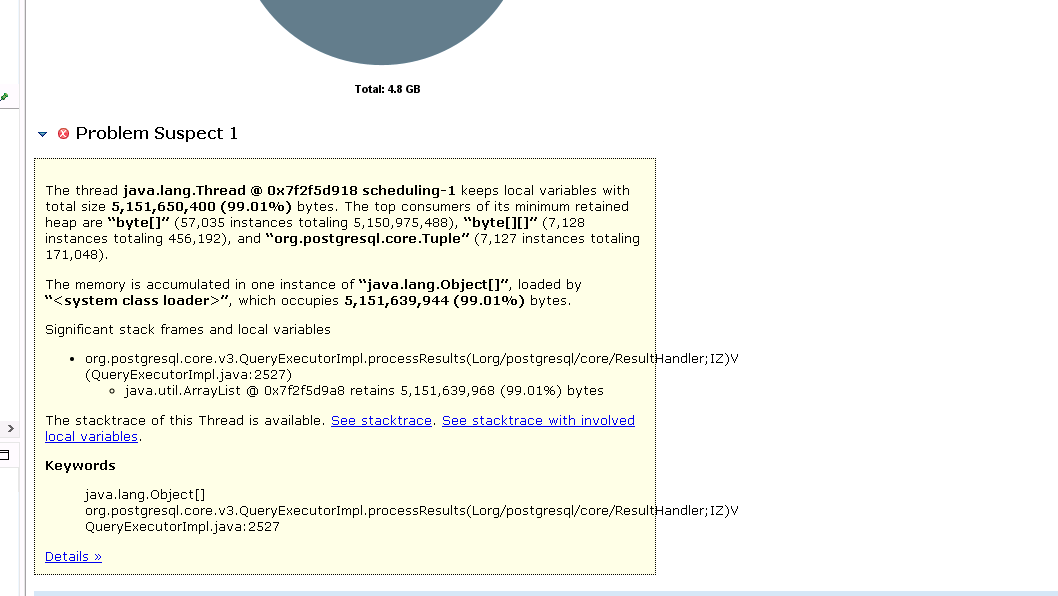
报告中的关键信息是:
retained heap(保留堆大小)表示:这个对象不再被引用后,连同它独占持有的对象,能释放多少内存。这里要找的是谁留住了大批数据。
这张报告说明大量内存用于保存 PostgreSQL 查询结果,还不能证明驱动有内存泄漏。MAT 分析的是某一时刻的快照,接下来要查这些结果从哪里来。MAT 报告说明
5. 从驱动栈继续找到自己的业务代码
在报告中点击 See stacktrace 或 See stacktrace with involved local variables,查看持有这些对象的线程当时正在做什么。
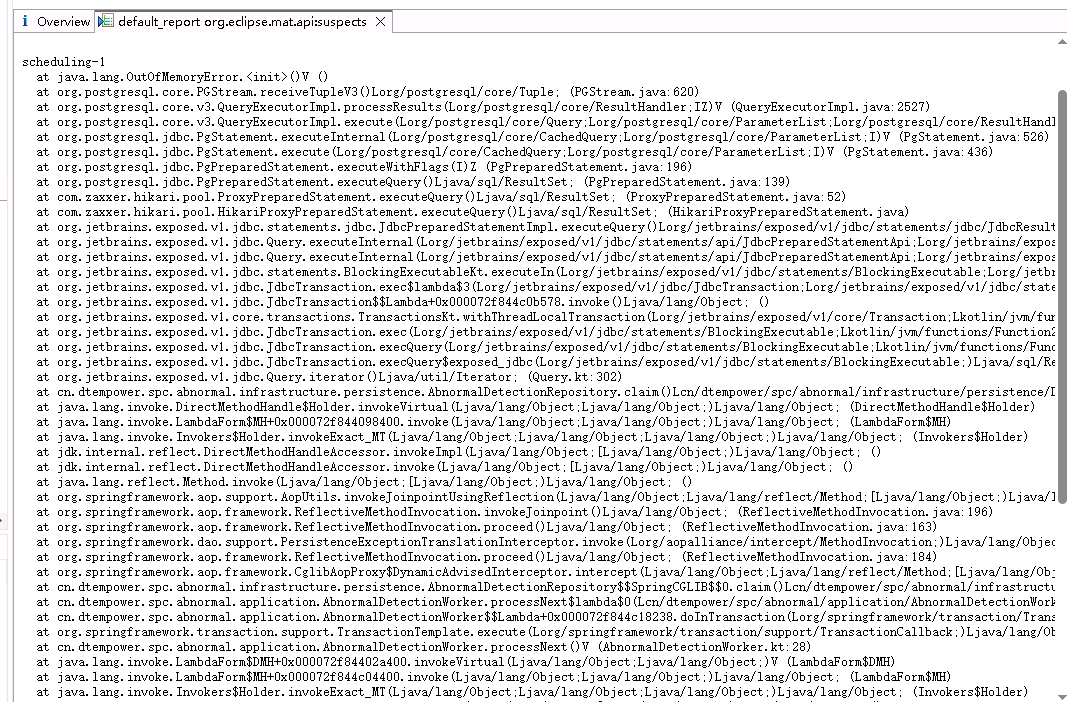
将完整调用栈压缩后,调用路径是:
AbnormalDetectionWorker.processNext
  → AbnormalDetectionRepository.claim
  → Exposed Query.iterator / executeQuery
  → Hikari ProxyPreparedStatement.executeQuery
  → PostgreSQL QueryExecutorImpl.processResults
  → PGStream.receiveTupleV3
  → OutOfMemoryError
从驱动和框架调用栈向上找,直到找到自己的代码。截图中的 AbnormalDetectionRepository.claim() 就是业务入口,负责从数据库领取待处理任务。排查自己的服务时,用同样的方法找到对应入口,再检查其中的查询。
6. 只取 ID 的代码,为什么读进来 5 GB
任务表中有一个 snapshot 字段,类型为 TEXT,保存任务执行所需的配置和数据,单条内容可能很大。
原代码使用 Kotlin 的 Exposed 数据库框架。简化表名后,关键逻辑如下:
val candidates = TaskTable
    .selectAll()
    .where {
        (TaskTable.status neq "DONE") and
            (TaskTable.availableAt lessEq now)
    }
    .orderBy(TaskTable.id to SortOrder.ASC)
    .map { it[TaskTable.id].value }
最后的 map 只取 ID,但它发生在结果返回之后。前面的 selectAll() 已经要求数据库返回所有字段,包括 snapshot;查询又没有限制行数,大量快照便一起进入驱动。
换成 SQL 就容易看清:业务需要 SELECT id,实际执行的却是包含大字段的 SELECT *。使用其他数据库框架时,也应检查最终生成的 SQL。
PostgreSQL 的 Java 驱动 pgJDBC 默认一次缓存全部查询结果,因此业务还没处理完 ID,就可能耗尽内存。默认缓存与分批获取说明
flowchart TD
    A[领取一个任务] --> B[查询所有候选任务的全部字段]
    B --> C[大量 snapshot 随结果返回]
    C --> D[JDBC 用 Tuple 和字节数组保存结果]
    D --> E[调度线程局部变量持有结果集]
    E --> F[Java 堆耗尽]
字段内容大小和返回行数相乘,结果可能很惊人。例如:
7,000 条任务 × 每条 700 KiB 快照 ≈ 4.67 GiB 原始内容
这是数量级示例,并非现场实测,还没计入数组和 JSON 解析等额外开销。截图中约 7,000 个 Tuple 和大批字节数组,也支持继续排查大结果集。
7. 为什么之前没问题,最近才报错
通过版本记录发现,这条查询早已存在。数据量小的时候,结果集还能放进堆里;随着数据增长或任务积压,同样的查询就可能耗尽内存。因此,最近出现故障不一定是最近修改了代码,还要对比任务数量、单条数据大小及内存配置。
8. 修复重点:控制读取字段和单次结果规模
这次修复围绕任务领取过程做了三件事:
候选扫描只查询 ID,固定本轮最大 ID,按游标每批最多读取 100 个编号。
锁定候选任务后,只读取状态、批次、租约等判断所需的小字段。
确认该任务可以领取,才单独读取并解析这一条
snapshot。
相关检查同样只查询必要字段,保留原有任务执行顺序和重试规则。
只加 LIMIT 100 仍可能读取 100 条大快照,因此要同时控制字段和行数。这里不需要候选任务的快照,直接不查询它,比调整驱动缓存更合适。
修改后重新部署,服务启动和后台任务运行恢复正常,未再出现本次 OOM 问题。