本文介绍 DTEmpower-SPC 平台如何通过 OCR 识别与大模型结合,实现 PDF 质量检测报告的自动化数据提取,将人工录入变为"上传-确认-入库"三步完成。
1. 背景:质检员的烦恼
在制造业的质量管控(SPC)场景中,质检员每天面对的是一摞又一摞的 PDF 格式质量检测报告。这些报告来自不同的供应商,格式五花八门——有的是表格,有的是纯文本,有的甚至图文混排。
传统的工作方式是:打开 PDF → 用眼睛找数据 → 手动敲进系统。一份报告可能要花半小时,一天下来录入几十份,不仅效率低,还容易看错数字、抄错行。
从业务侧看,这类质量数据处理长期存在三个突出痛点:
处理效率低、分析滞后:海量质量数据依赖人工逐份录入和识别,处理周期长,问题发现不及时。
误判漏判风险高:人工分析容易受经验、疲劳和格式差异影响,导致异常识别不稳定,影响质量决策准确性。
数据价值难挖掘:大量 PDF 报告沉淀为离散文件,难以及时汇聚到 SPC 分析链路中,潜在趋势、异常模式和质量风险无法被充分利用。
我们的目标是:让机器来干这个活。用户只需上传 PDF,系统自动完成 OCR 识别 → 大模型结构化提取 → 人工确认 → 数据入库,整个流程从"小时级"压缩到"分钟级"。
围绕这个目标,智能数据提取能力重点解决三件事:
效率提升:AI 自动处理质量数据,识别筛选效率提升 80% 以上。
人力优化:减少 70% 人工处理工作量,让人员从重复录入转向质量决策和改进。
精准洞察:AI 智能识别异常,实现质量问题实时预警与精准定位。
2. 整体思路:三步走
整个功能的核心思路可以用三句话概括:
OCR 识别:用 PaddleOCR 把 PDF 变成机器可读的文本(Markdown)和图片
大模型提取:用 AI 大模型从文本中"读懂"表格结构,抽取出结构化的样本数据
人工确认 + 入库:用户在前端对比审核,确认无误后一键入库
整体架构如下:
flowchart TB
    subgraph 用户操作
        Upload[上传 PDF]
        Review[OCR 对比审核]
        Commit[确认入库]
    end

    subgraph 系统处理
        OCR[百度 PaddleOCR<br/>版面分析 + 文字识别]
        LLM[大模型 API<br/>结构化数据抽取]
        DB[(PostgreSQL)]
    end

    Upload --> OCR
    OCR -->|图片 + Markdown| Review
    Review -->|触发提取| LLM
    LLM -->|结构化数据| Review
    Review -->|确认入库| DB
用更通俗的话说:PDF 就像一封"加密信",OCR 负责把信"翻译"成中文,大模型负责从翻译出来的内容中"挑重点",最后由人工把关确认。
3. 关键技术点
3.1 OCR 识别:选 PaddleOCR 的理由
PDF 报告最大的难点在于版面复杂。一份报告里可能同时包含表格、段落文字、图片、页眉页脚,甚至印章和签名。普通的文字识别工具只能识别出一坨纯文本,完全丢失了表格结构。
我们选用的是百度 PaddleOCR VL 1.6,它支持版面分析(Layout Analysis),能够:
识别出 PDF 中的文本块、表格、图片等区域
按照阅读顺序排列各个区块
为每个区块提供坐标位置(用于前端框选定位)
输出结构化的 Markdown 文本
OCR 调用采用了异步任务模式:提交任务 → 轮询状态 → 下载结果,这是因为 PDF 解析通常需要十几秒,同步等待不现实。
// 提交 OCR 任务
val jobId = submitOcrJob(jobUrl, token, model, pdfPath, pdfBytes)

// 轮询任务状态(每 5 秒一次,最多 100 秒)
while (pollCount < maxPolls) {
    Thread.sleep(5000)
    val response = baiduOcrClient.getJobStatus(uri = URI.create(pollUrl), authorization = "bearer $token")
    when (response.data?.state) {
        "done" -> return downloadAndParseResults(response.data.resultUrl.jsonUrl)
        "failed" -> throwOcrDownstreamFailed()
        // pending / running 继续等待...
    }
    pollCount++
}
每页 PDF 识别后会产出两样东西:一张页面图片和一份 Markdown 文本。图片用于前端展示,Markdown 用于后续大模型提取。
3.2 大模型结构化提取:Prompt 是核心
OCR 解决了"看清"的问题,但还不能直接用——Markdown 文本里混杂着各种内容,我们需要的是特定的样本数据,比如采样时间、测量值、工号等。
这就是大模型的用武之地。我们使用 Koog AI Agent 框架(JetBrains 出品的 Kotlin AI 框架)来构建提取 Agent,核心思路是:
通过 System Prompt 告诉大模型"你是谁、怎么提取"
通过 User Prompt 填充模板信息和 OCR 文本
通过 结构化输出(Structured Output)强制大模型返回 JSON 格式
System Prompt 的关键规则(精简展示):
// DocumentExtractionPrompts.kt
val intelligentExtractionPrompt: String by lazy {
    """
    你是一个结构化数据抽取助手。

    任务目标:
    根据给定的 OCR 文本内容,结合预先定义的智能提取模板,抽取出用于系统入库的结构化数据。

    输出要求:
    1. 只输出 JSON 对象,不要输出解释说明,不要使用 Markdown 代码块。
    4. sampleDataList 中每一项都必须带上固定的 materialId(物料 ID)。
    6. sampleTime 需要转换为 ISO 8601 的东八区时间字符串。
    7. metadata 中的 name 必须使用模板中的 metadataName,value 来自 OCR 文本。
    11. 不要臆造数据,只提取 OCR 文本中能够明确识别的信息。
    12. 如果某个单元格为空或无法辨认,则跳过,不要臆造数值。
    """.trimIndent()
}
User Prompt 的拼装逻辑:把模板信息和 OCR 文本组装成完整的输入。
// DocumentExtractionPrompts.kt
fun buildIntelligentExtractionInput(template: RuntimeExtractionTemplate, markdown: String): String =
    buildString {
        appendLine("请根据如下提示从 OCR 识别的 markdown 中提取结构化数据:")
        appendLine("### 已知模板信息:")
        appendLine(" - 物料 ID:${template.materialId}")
        appendLine(" - 物料名称:${template.materialName}")
        appendLine(" - 样本信息映射列表:")
        template.metadataMappings.forEachIndexed { index, mapping ->
            appendLine(" - metadataName=${mapping.metadataName}; documentFieldName=${mapping.documentFieldName}; remark=${mapping.remark}")
        }
        appendLine("### 额外约束:")
        appendLine(template.constraintText)
        appendLine("### OCR Markdown 文本如下:")
        appendLine(markdown)
    }
结构化输出定义:通过 Kotlin 序列化 + @LLMDescription 注解,让大模型严格按 schema 输出。
// LlmSampleExtractionResult.kt
@Serializable
@LLMDescription("智能数据提取统一输出结果。")
data class LlmSampleExtractionResult(
    @property:LLMDescription("样本数据列表。没有识别到样本数据时输出空数组。")
    val sampleDataList: List<LlmExtractionSampleDataItem> = emptyList(),
)

@Serializable
@LLMDescription("单条样本数据,用于承载后续入库所需的核心字段。")
data class LlmExtractionSampleDataItem(
    @property:LLMDescription("物料 ID,直接使用模板中的物料 ID。")
    val materialId: Long,
    @property:LLMDescription("采样时间,必须为 ISO 8601 的 UTC 时间字符串。")
    val sampleTime: String,
    @property:LLMDescription("计量型采样值。")
    val variableValue: Double? = null,
    @property:LLMDescription("样本信息列表。")
    val metadata: List<LlmExtractionMetadataValueItem> = emptyList(),
)
Agent 创建:设置 temperature = 0.1(低随机性,保证提取稳定性)和 maxAgentIterations = 1(单次调用,不做多轮对话)。
// DocumentExtractionAgentFactory.kt
fun createIntelligentExtractionAgent(): AIAgent<String, LlmSampleExtractionResult> {
    return AIAgent(
        promptExecutor = openAIExecutor,
        strategy = functionalStrategy("intelligent-data-extraction") { markdown ->
            requestLLMStructured<LlmSampleExtractionResult>(markdown).getOrThrow().data
        },
        agentConfig = AIAgentConfig(
            prompt = prompt(id = "intelligent-data-extraction-agent", params = LLMParams(temperature = 0.1)) {
                system(DocumentExtractionPrompts.intelligentExtractionPrompt)
            },
            model = buildCompatibleModel(properties.spc.extractAgent.model),
            maxAgentIterations = 1,
        ),
    )
}
模板机制:让提取"有的放矢"
不同的报告需要提取不同的字段。我们设计了一个模板机制,用户可以配置:
提取哪个物料、哪个特性的数据
每个样本信息(如工号、机台号)在 PDF 中对应的字段名
额外的提取约束(如"只提取前 10 行数据")
模板的核心数据结构:
data class RuntimeExtractionTemplate(
    val materialId: Long,
    val materialName: String,
    val characteristicId: Long,
    val characteristicName: String,
    val metadataMappings: List<RuntimeExtractionMetadataMapping>,
    val constraintText: String = "",
)

data class RuntimeExtractionMetadataMapping(
    val metadataId: Long,
    val metadataName: String,      // 系统中的字段名
    val documentFieldName: String,  // PDF 中的字段名
    val remark: String = "",        // 备注说明
)
这样,同一个 PDF 报告,配合不同的模板,可以提取出不同维度的数据——灵活性很高。
3.3 前端交互:左右联动的 OCR 对比页
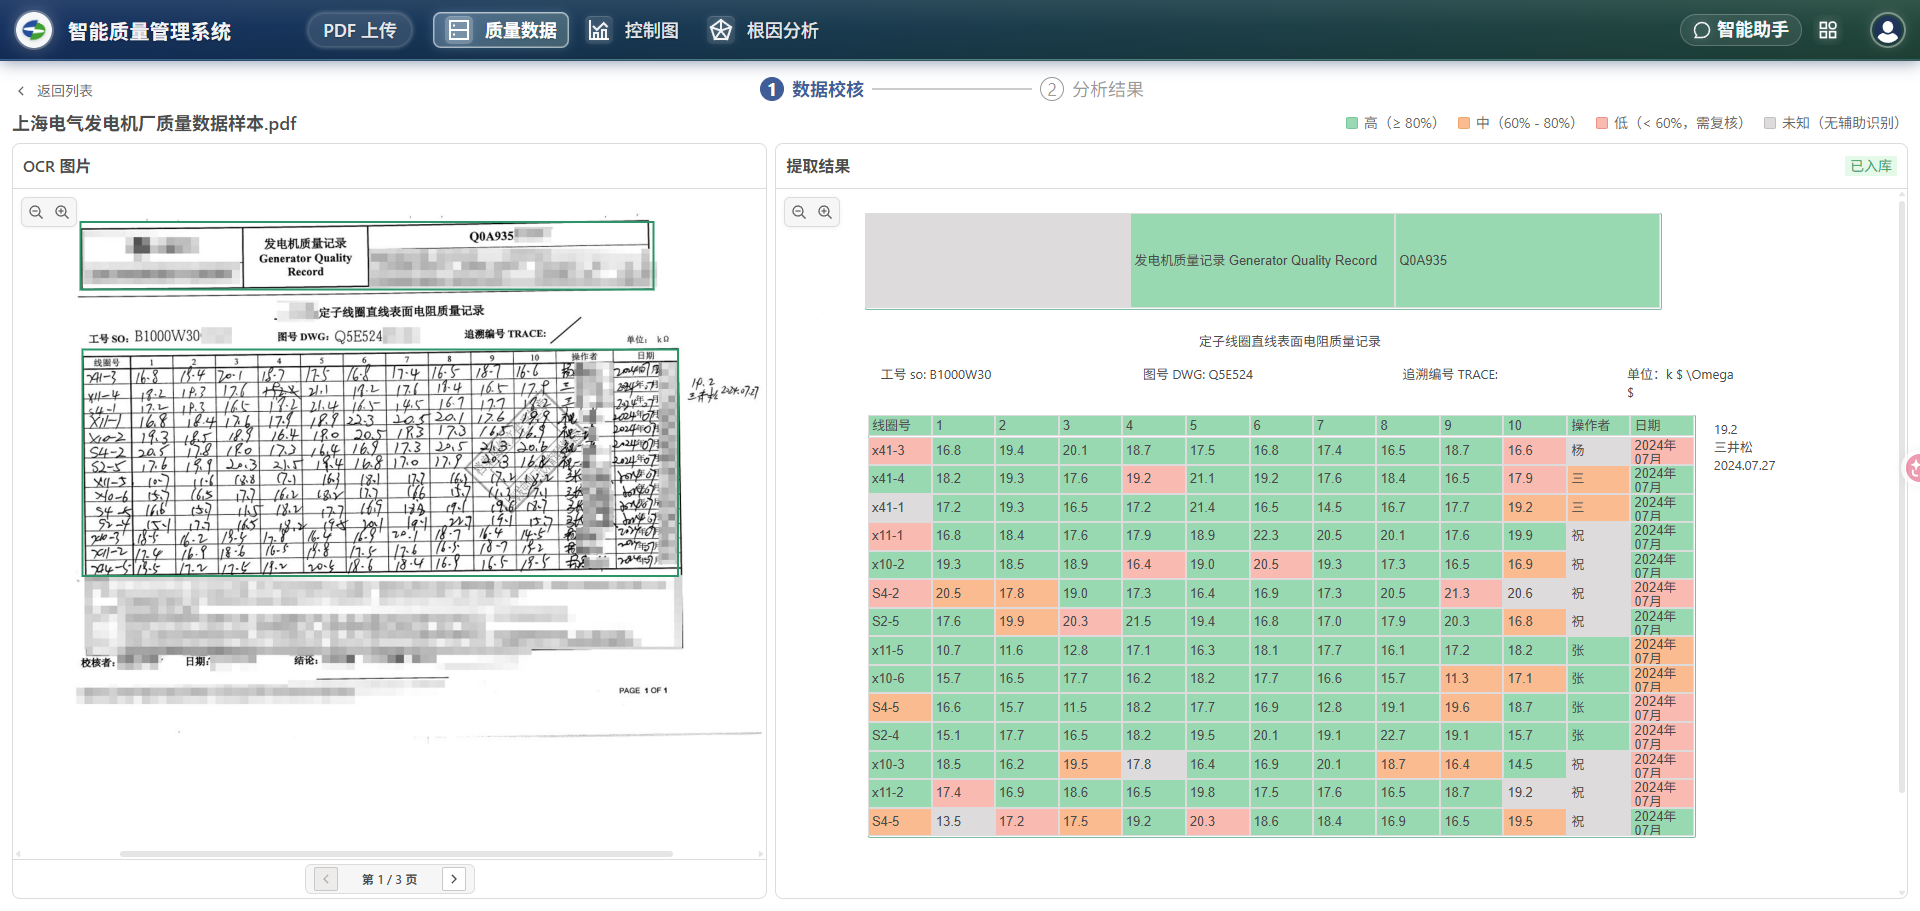
前端最有挑战的部分是OCR 对比页。左侧是 PDF 原图,右侧是 OCR 识别结果,用户可以:
Hover 联动:鼠标悬停左侧图片上的区块,右侧对应的文本块高亮;反之亦然
选中定位:点击左侧区块,右侧自动滚动到对应位置
直接编辑:OCR 识别有误时,用户可以直接在右侧修改文本
这种左右联动的交互设计,让用户能快速校验 OCR 结果的准确性,大大降低了审核成本。
4. 数据流全景
把上面的技术点串联起来,完整的数据流是这样的:
sequenceDiagram
    actor 用户
    participant 前端
    participant 后端
    participant OCR as PaddleOCR
    participant LLM as 大模型
    participant DB as 数据库

    用户->>前端: 上传 PDF
    前端->>后端: POST /api/intelligent-extraction/pdfs
    后端->>DB: 保存文档记录(状态:uploaded)
    后端->>OCR: 提交 OCR 识别任务
    后端-->>前端: 返回文档 ID

    Note over 后端,OCR: 后台异步执行
    OCR-->>后端: 识别完成,返回图片 + Markdown
    后端->>DB: 保存分页数据(状态:ocr_succeeded)

    用户->>前端: 进入 OCR 对比页审核
    前端->>后端: 获取 OCR 结果
    后端-->>前端: 返回图片 + 文本

    用户->>前端: 点击"数据提取"
    前端->>后端: POST /extract-data
    后端->>LLM: 发送 Prompt + OCR 文本
    LLM-->>后端: 返回结构化数据
    后端->>DB: 暂存提取结果

    用户->>前端: 确认数据无误,点击"入库"
    前端->>后端: POST /staging-sample-data/commit
    后端->>DB: 写入正式样本数据
    后端-->>前端: 入库成功
值得注意的是,数据不会直接入库,而是先放入"暂存区"。用户确认无误后才写入正式的样本数据表。这个设计保证了数据质量——毕竟 AI 再聪明,也需要人来把最后一道关。
5. 技术栈一览
6. 效果一览
1.ocr结果预览
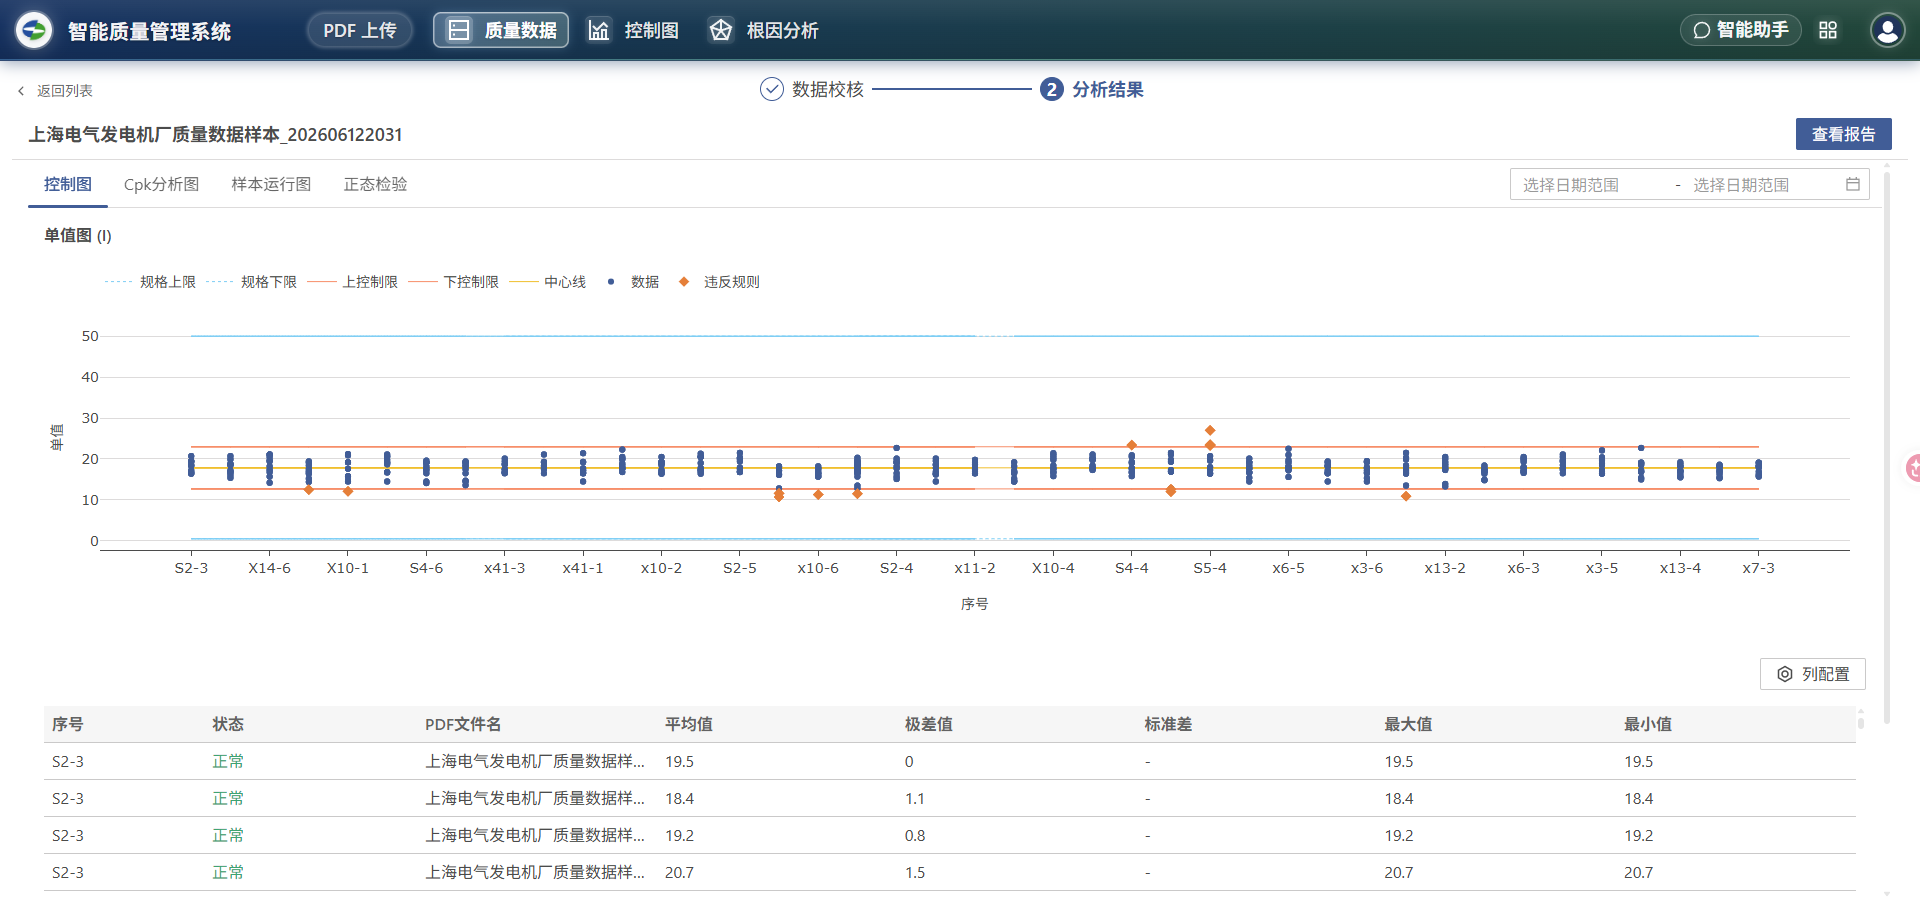
2.结构化数据出控制图
附录:核心后端代码
下面按后端调用链展开关键实现。代码片段保留主干逻辑,省略了部分 DTO 映射和异常参数,便于阅读。
1. 接口层:PDF 全生命周期 API
智能提取的 HTTP 入口集中在 IntelligentExtractionController。从上传、分页查询、图片下载、模板绑定,到页级数据提取、暂存查询、最终入库,都是围绕同一个 PDF 文档 ID 展开。
// IntelligentExtractionController.kt
@Tag(name = "IntelligentExtraction", description = "智能数据提取")
@RestController
@RequestMapping("/api/intelligent-extraction/pdfs")
class IntelligentExtractionController(
    private val pdfExtractionService: PdfExtractionService,
) {
    @Operation(summary = "上传 PDF 并解析")
    @PostMapping(consumes = [MediaType.MULTIPART_FORM_DATA_VALUE])
    @ResponseStatus(HttpStatus.CREATED)
    fun upload(
        @AuthenticationPrincipal principal: IdentityPrincipal,
        @RequestPart("file") file: MultipartFile,
    ): PdfUploadResponse =
        pdfExtractionService
            .upload(
                UploadPdfCommand(
                    fileName = file.originalFilename ?: "upload.pdf",
                    bytes = file.bytes,
                    creatorId = principal.id,
                ),
            ).toResponse()

    @Operation(summary = "已解析 PDF 列表")
    @GetMapping
    fun listDocuments(
        @Valid @ParameterObject request: PdfDocumentPageRequest,
    ): PageResult<PdfDocumentSummaryView> =
        pdfExtractionService
            .listDocuments(request.toQuery())
            .toSummaryResponsePage()

    @Operation(summary = "查询 PDF 全部分页")
    @GetMapping("/{id}/pages")
    fun listPages(@PathVariable id: Long): ListResult<PdfExtractionPageView> =
        ListResult(items = pdfExtractionService.listPages(id).map { it.toResponse() })

    @Operation(summary = "抽取 PDF 分页结构化数据")
    @PostMapping("/{id}/pages/{page_index}/extract-data")
    @ResponseStatus(HttpStatus.ACCEPTED)
    fun extractPageData(
        @AuthenticationPrincipal principal: IdentityPrincipal,
        @PathVariable id: Long,
        @PathVariable("page_index") pageIndex: Int,
    ): PdfPageDataExtractionStatusItemView =
        pdfExtractionService
            .submitPageDataExtraction(id, pageIndex, principal.id)
            .toResponse()

    @Operation(summary = "查询 PDF 分页结构化抽取暂存数据")
    @GetMapping("/{id}/pages/{page_index}/staging-sample-data")
    fun listStagingSampleData(
        @PathVariable id: Long,
        @PathVariable("page_index") pageIndex: Int,
    ): ListResult<PdfExtractionSampleDataStagingView> =
        ListResult(items = pdfExtractionService.listStagingSampleData(id, pageIndex).map { it.toResponse() })

    @Operation(summary = "将 PDF 暂存结构化数据写入正式样本数据")
    @PostMapping("/{id}/staging-sample-data/commit")
    @ResponseStatus(HttpStatus.NO_CONTENT)
    fun commitStagingSampleData(
        @AuthenticationPrincipal principal: IdentityPrincipal,
        @PathVariable id: Long,
    ) = pdfExtractionService.commitStagingSampleData(id, principal.id)

    @Operation(summary = "绑定 PDF 解析模板")
    @PutMapping("/{id}/template")
    fun bindTemplate(
        @PathVariable id: Long,
        @Valid @RequestBody request: PdfDocumentTemplateBindRequest,
    ): PdfDocumentSummaryView =
        pdfExtractionService.bindTemplate(id, request.toCommand()).toResponse()

    @Operation(summary = "审核 PDF 文档")
    @PutMapping("/{id}/review")
    fun reviewDocument(@PathVariable id: Long): PdfDocumentSummaryView =
        pdfExtractionService.reviewDocument(id).toResponse()
}
这个接口设计有两个特点:
页级 OCR 结果和页级结构化提取状态分开,前端可以细粒度刷新。
数据提取是
202 Accepted异步任务,避免大模型调用阻塞用户请求。
2. 上传入口:MD5 去重、文件落盘与 OCR 投递
上传时后端不会直接解析 PDF,而是先做文件名校验、MD5 计算和去重。相同文件再次上传时,如果本地 OCR 产物完整,就直接复用;如果本地文件缺失,则清理旧分页和暂存数据后重新识别。
// PdfExtractionService.kt
fun upload(command: UploadPdfCommand): PdfUploadResult {
    val fileName = command.fileName
    validatePdfFileName(fileName)

    val pdfBytes = command.bytes
    val md5 = fileService.md5(pdfBytes)
    val existingDocument = documentService.findDocumentByMd5(md5)
    if (existingDocument != null) {
        val pages = documentService.findPagesByDocumentId(existingDocument.id)
        val localFilesComplete =
            isLocalRecognitionComplete(
                md5 = existingDocument.md5,
                status = existingDocument.status,
                pageIndexes = pages.map { it.pageIndex },
            )

        if (!localFilesComplete) {
            val pdfPath = fileService.saveUploadedPdf(md5, pdfBytes)
            stagingSampleDataService.deleteDocumentData(existingDocument.id)
            documentService.deletePagesByDocumentId(existingDocument.id)
            documentService.updateStatus(existingDocument.id, PdfExtractionStatus.UPLOADED)
            asyncService.submitOcrRecognition(existingDocument.id, existingDocument.fileName, pdfPath, pdfBytes)
        }

        return PdfUploadResult(
            id = existingDocument.id,
            fileName = existingDocument.fileName,
            pageCount = if (localFilesComplete) pages.size else 0,
        )
    }

    val pdfPath = fileService.saveUploadedPdf(md5, pdfBytes)
    val document = persistenceService.createUploadedDocument(fileName, md5, command.creatorId)
    asyncService.submitOcrRecognition(document.id, fileName, pdfPath, pdfBytes)

    return PdfUploadResult(
        id = document.id,
        fileName = document.fileName,
        pageCount = 0,
    )
}

private fun validatePdfFileName(fileName: String) {
    if (!fileName.lowercase().endsWith(".pdf")) {
        throw InvalidRequestException("error.pdf_extraction.pdf_only")
    }
    if (fileName.length > 255) {
        throw InvalidRequestException("error.pdf_extraction.file_name_too_long")
    }
}
本地识别结果完整性检查会同时确认原始 PDF、文档状态和各页识别文件:
// PdfExtractionService.kt
private fun isLocalRecognitionComplete(
    md5: String,
    status: PdfExtractionStatus,
    pageIndexes: List<Int>,
): Boolean {
    if (!fileService.uploadedPdfExists(md5)) {
        return false
    }
    if (status == PdfExtractionStatus.UPLOADED) {
        return true
    }
    if (status == PdfExtractionStatus.OCR_FAILED || pageIndexes.isEmpty()) {
        return false
    }
    return pageIndexes.all { pageIndex -> fileService.pageRecognitionFilesExist(md5, pageIndex) }
}
文件操作统一收口到 PdfRecognitionFileService,它屏蔽了本地目录结构,业务层只关心“按 md5 读写 PDF、图片和 Markdown”。
// PdfRecognitionFileService.kt
@Service
class PdfRecognitionFileService(
    private val store: LocalPdfRecognitionStore,
) {
    fun md5(bytes: ByteArray): String = store.md5(bytes)

    fun saveUploadedPdf(md5: String, bytes: ByteArray): Path =
        store.saveUploadedPdf(md5, bytes)

    fun pageRecognitionFilesExist(md5: String, pageIndex: Int): Boolean =
        store.pageRecognitionFilesExist(md5, pageIndex)

    fun readPageImageBytes(md5: String, pageIndex: Int): ByteArray =
        store.readPageImageBytes(md5, pageIndex)

    fun readPageMarkdownText(md5: String, pageIndex: Int): String =
        store.readPageMarkdownText(md5, pageIndex)

    fun writePageMarkdown(md5: String, pageIndex: Int, content: String) {
        store.writePageMarkdown(md5, pageIndex, content)
    }
}
3. OCR 异步任务:PaddleOCR 调用与分页状态
OCR 是后台任务,由 TaskExecutor 投递。任务成功后保存分页数据并把文档状态改成 PENDING_REVIEW;失败则标记为 OCR_FAILED。
// PdfExtractionAsyncService.kt
fun submitOcrRecognition(
    documentId: Long,
    fileName: String,
    pdfPath: Path,
    pdfBytes: ByteArray,
) {
    taskExecutor.execute {
        runOcrRecognition(documentId, fileName, pdfPath, pdfBytes)
    }
}

private fun runOcrRecognition(
    documentId: Long,
    fileName: String,
    pdfPath: Path,
    pdfBytes: ByteArray,
) {
    try {
        val parseResult = pdfOcrService.parse(fileName, pdfPath, pdfBytes)
        persistenceService.saveOcrSucceededPages(documentId, parseResult.pages)
    } catch (e: Exception) {
        log.error(e) { "PDF OCR task failed: documentId=$documentId, fileName=$fileName" }
        persistenceService.markOcrFailed(documentId)
    }
}
OCR 服务本身非常薄,只负责把文件交给 PaddleOCR 网关,把结果转换成系统内部的 PdfExtractionPageInput。
// PdfOcrService.kt
data class PdfOcrResult(
    val pages: List<PdfExtractionPageInput>,
)

@Service
class PdfOcrService(
    private val paddleOcrGateway: PaddleOcrGateway,
) {
    fun parse(
        fileName: String,
        pdfPath: Path,
        pdfBytes: ByteArray,
    ): PdfOcrResult =
        PdfOcrResult(
            pages = paddleOcrGateway.parse(fileName, pdfPath, pdfBytes).pages,
        )
}
分页持久化由 PdfDocumentService 负责。OCR 成功后,文档状态进入待审核,分页 OCR 结构被整体替换,保证一次识别结果对应一组干净分页数据。
// PdfDocumentService.kt
fun saveOcrSucceededPages(
    documentId: Long,
    pages: List<PdfExtractionPageInput>,
): PdfExtractionDocument {
    val document = documentRepository.updateStatus(documentId, PdfExtractionStatus.PENDING_REVIEW)
    pageRepository.replaceByDocumentId(document.id, pages)
    return document
}
4. OCR 人工校正:分页更新会清理旧暂存结果
OCR 结果允许人工修正。只要用户修改了某页 Markdown 或页面结构,后端就会清理该页已有的暂存提取结果,并把页级提取状态重置为 NONE,避免旧提取结果和新 OCR 文本不一致。
// PdfExtractionService.kt
fun updatePage(
    documentId: Long,
    pageIndex: Int,
    command: UpdatePdfExtractionPageCommand,
): PdfExtractionPageResult {
    ensurePageIndexValid(pageIndex)
    validatePageUpdateCommand(command)

    val document = requireDocumentById(documentId)

    fileService.writePageMarkdown(document.md5, pageIndex, command.markdown)
    val existingPage =
        documentService.findPageByDocumentIdAndPageIndex(document.id, pageIndex)
            ?: throwPageNotFound(documentId, pageIndex)

    val mergedPageData =
        command.pageData
            .toDomain()
            .copy(ppOcrData = existingPage.pageData.ppOcrData)

    val page =
        documentService.updatePageData(document.id, pageIndex, mergedPageData)
            ?: throwPageNotFound(documentId, pageIndex)

    stagingSampleDataService.deletePageData(document.id, pageIndex)
    documentService.updatePageStatus(document.id, pageIndex, PdfPageDataExtractionStatus.NONE)
        ?: throwPageNotFound(documentId, pageIndex)
    documentService.touch(document.id)

    return toPageResult(documentService.findDocumentById(document.id) ?: document, page)
}
这里保留 ppOcrData 的原因是:前端人工修订主要修改 VL 识别结构和 Markdown,而 PP-OCR 表格补充信息作为识别辅助结果,不应被普通页面保存覆盖掉。
5. 模板装配:从配置模板变成运行时提取模板
大模型并不是拿 OCR 文本“自由发挥”,而是拿到一个运行时模板。模板工厂会把模板 ID 展开成物料、质量特性、样本信息映射和提取约束。
// PdfExtractionTemplateFactory.kt
@Component
class PdfExtractionTemplateFactory(
    private val templateService: IntelligentExtractionTemplateService,
    private val materialService: MaterialService,
    private val characteristicService: CharacteristicService,
    private val materialMetadataService: MaterialMetadataService,
) {
    fun create(templateId: Long): RuntimeExtractionTemplate {
        val template = templateService.requireById(templateId)
        val material = materialService.getById(template.materialId)
        val characteristic =
            characteristicService.getByIdAndMaterialId(template.characteristicId, template.materialId)

        if (characteristic.dataType != CharacteristicDataType.VARIABLE) {
            throw ApplicationException(
                "error.intelligent_extraction_template.characteristic_type_unsupported",
                httpStatus = HttpStatus.UNPROCESSABLE_ENTITY,
            )
        }

        return RuntimeExtractionTemplate(
            materialId = material.id,
            materialName = material.name,
            characteristicId = characteristic.id,
            characteristicName = characteristic.name,
            metadataMappings =
                template.metadataMappings.map { mapping ->
                    val metadata = materialMetadataService.requireById(mapping.metadataId)
                    RuntimeExtractionMetadataMapping(
                        metadataId = mapping.metadataId,
                        metadataName = metadata.name,
                        documentFieldName = mapping.matchValue.ifBlank { metadata.name },
                        remark = mapping.remark,
                    )
                },
            constraintText = template.constraintText,
        )
    }
}
这一层做了两个关键限制:
当前 PDF 智能提取只支持计量型质量特性。
PDF 字段名和系统样本信息名分开,用户可以配置“PDF 中叫 A,系统里叫 B”的映射关系。
6. 页级大模型提取:状态校验、Prompt 输入和异步执行
用户点击某页“数据提取”时,后端先检查页面和文档状态。只有 PENDING_REVIEW、REVIEWED、COMMITTED 三类文档允许重新提取;同时必须绑定模板,并且 Markdown 不能为空。
// PdfExtractionService.kt
fun submitPageDataExtraction(
    documentId: Long,
    pageIndex: Int,
    creatorId: Long,
): PdfPageDataExtractionStatusItemResult {
    ensurePageIndexValid(pageIndex)

    val document = persistenceService.getDocumentForPageExtraction(documentId, pageIndex)
    val templateId =
        document.templateId
            ?: throw ApplicationException("error.pdf_extraction.template_required", httpStatus = HttpStatus.UNPROCESSABLE_ENTITY)

    val markdown = fileService.readPageMarkdownText(document.md5, pageIndex).trim()
    if (markdown.isBlank()) {
        throw ApplicationException(
            "error.pdf_extraction.page_markdown_empty",
            messageArgs = arrayOf<Any?>(documentId, pageIndex),
            httpStatus = HttpStatus.UNPROCESSABLE_ENTITY,
        )
    }

    val template = templateFactory.create(templateId)
    val page = asyncService.submitDataExtraction(documentId, pageIndex, markdown, template, creatorId)
    val stagingCount = stagingSampleDataService.countGroupedByPageIndex(documentId)[pageIndex] ?: 0

    return PdfPageDataExtractionStatusItemResult(
        pageIndex = page.pageIndex,
        status = page.status,
        stagingCount = stagingCount,
        updatedAt = page.updatedAt,
    )
}
状态校验集中在持久化服务里,保证异步任务启动前页面一定存在。
// PdfExtractionPersistenceService.kt
fun getDocumentForPageExtraction(
    documentId: Long,
    pageIndex: Int,
): PdfExtractionDocument {
    val document = requireDocumentById(documentId)

    if (
        document.status != PdfExtractionStatus.PENDING_REVIEW &&
        document.status != PdfExtractionStatus.REVIEWED &&
        document.status != PdfExtractionStatus.COMMITTED
    ) {
        throw ConflictException("error.pdf_extraction.status_not_extractable")
    }
    if (document.templateId == null) {
        throw ApplicationException("error.pdf_extraction.template_required", httpStatus = HttpStatus.UNPROCESSABLE_ENTITY)
    }

    requirePage(document.id, pageIndex)
    return document
}
异步提取时,先将页面状态标记为 RUNNING,然后调用 SampleExtractionService。成功则替换暂存数据,失败则标记为 FAILED。
// PdfExtractionAsyncService.kt
fun submitDataExtraction(
    documentId: Long,
    pageIndex: Int,
    markdown: String,
    template: RuntimeExtractionTemplate,
    creatorId: Long,
): PdfExtractionPage {
    val page =
        persistenceService.markPageDataExtractionStatus(
            documentId,
            pageIndex,
            PdfPageDataExtractionStatus.RUNNING,
        )

    taskExecutor.execute {
        runDataExtraction(documentId, pageIndex, markdown, template, creatorId)
    }

    return page
}

private fun runDataExtraction(
    documentId: Long,
    pageIndex: Int,
    markdown: String,
    template: RuntimeExtractionTemplate,
    creatorId: Long,
) {
    try {
        val result =
            runBlocking {
                sampleExtractionService.extractByTemplate(markdown, template)
            }
        persistenceService.replaceStagingSampleData(
            documentId,
            pageIndex,
            result.sampleDataList,
            creatorId,
        )
    } catch (e: Exception) {
        log.error(e) { "PDF page data extraction task failed: documentId=$documentId, pageIndex=$pageIndex" }
        runCatching {
            persistenceService.markPageDataExtractionStatus(documentId, pageIndex, PdfPageDataExtractionStatus.FAILED)
        }
    }
}
大模型提取入口会统一检查 Markdown 内容,然后把“模板 + OCR 文本”交给 LLM 服务。
// SampleExtractionService.kt
@Service
class SampleExtractionService(
    private val documentExtractionService: DocumentExtractionService,
) {
    suspend fun extractByTemplate(
        markdownContent: String,
        template: RuntimeExtractionTemplate,
    ): SampleExtractionResult {
        val normalizedContent = markdownContent.trim()
        if (normalizedContent.isBlank()) {
            throw ApplicationException(
                "error.pdf_extraction.page_markdown_empty",
                httpStatus = HttpStatus.UNPROCESSABLE_ENTITY,
            )
        }
        return documentExtractionService.extractByTemplate(normalizedContent, template)
    }

    fun buildPromptPreview(
        template: RuntimeExtractionTemplate,
        markdownPlaceholder: String,
    ): String = DocumentExtractionPrompts.buildIntelligentExtractionInput(template, markdownPlaceholder)
}
7. Prompt 构建与结构化输出
Prompt 分为两层:系统 Prompt 固定规则,用户 Prompt 填充运行时模板和 OCR Markdown。
// DocumentExtractionPrompts.kt
val intelligentExtractionPrompt: String by lazy {
    """
    你是一个结构化数据抽取助手。

    任务目标:
    根据给定的 OCR 文本内容,结合预先定义的智能提取模板,抽取出用于系统入库的结构化数据。

    输出要求:
    1. 只输出 JSON 对象,不要输出解释说明,不要使用 Markdown 代码块。
    2. 顶层只包含 sampleDataList 字段,不要输出其他字段。
    3. sampleDataList 必须是数组,没有识别到样本数据时输出空数组 []。
    4. sampleDataList 中每一项都必须带上固定的 materialId,值直接使用模板传入的物料 ID。
    5. sampleDataList 中每一项都必须带上固定的 characteristicId,值直接使用模板传入的特性 ID。
    6. sampleDataList 中每一项都必须包含 sampleTime,表示采样时间,需要将抽取到的时间格式
       拼接时区偏移转换为 ISO 8601 的东八区时间字符串,如"2026-05-27T18:39:00+08:00"。
    7. metadata 中 name 必须使用 metadataName,value 来自 OCR 文本中 documentFieldName 对应的识别结果值。
    8. 如果某个样本信息没有识别到值,则在 metadata 中不要输出对应项。
    9. 可以参考 remark 和额外约束辅助判断字段含义,但不要凭空编造数据。
    10. 所有字段名必须严格保持约定,不要新增字段,不要修改字段名。
    11. 不要臆造数据,只提取 OCR 文本中能够明确识别的信息。
    12. 如果某个测点单元格为空、明显被删除、无法辨认,则跳过该测点,不要臆造数值。
    13. 抽取数据时要注意保持每一条数据的顺序不要变。
    14. sampleData 对应每一条记录,其中 variableValue 对应样本值、测点值、采样值等。
    """.trimIndent()
}
用户 Prompt 把模板上下文、字段映射、额外约束和 OCR Markdown 串起来:
// DocumentExtractionPrompts.kt
fun buildIntelligentExtractionInput(
    template: RuntimeExtractionTemplate,
    markdown: String,
): String =
    buildString {
        appendLine("请根据如下提示从 OCR 识别的 markdown 中提取结构化数据:")
        appendLine()
        appendLine("### 已知模板信息:")
        appendLine(" - 物料 ID:${template.materialId}")
        appendLine(" - 物料名称:${template.materialName}")
        appendLine(" - 质量特性 ID:${template.characteristicId}")
        appendLine(" - 质量特性名称:${template.characteristicName}")
        appendLine(" - 样本信息映射列表:")
        template.metadataMappings.forEachIndexed { index, mapping ->
            appendLine(
                "   ${index + 1}. metadataName=${mapping.metadataName}; " +
                    "documentFieldName=${mapping.documentFieldName}; remark=${mapping.remark}",
            )
        }
        appendLine()
        appendLine("### 额外约束:")
        appendLine(template.constraintText.ifBlank { "无" })
        appendLine()
        appendLine("### OCR Markdown 文本如下:")
        appendLine(markdown)
    }
结构化输出对象只承载入库需要的字段。这样即使 OCR Markdown 内容很复杂,后续入库层仍然只处理稳定的数据结构。
// LlmSampleExtractionResult.kt
@Serializable
@LLMDescription("智能数据提取统一输出结果。")
data class LlmSampleExtractionResult(
    @property:LLMDescription("样本数据列表。没有识别到样本数据时输出空数组。")
    val sampleDataList: List<LlmExtractionSampleDataItem> = emptyList(),
)

@Serializable
@LLMDescription("单条样本数据,用于承载后续入库所需的核心字段。")
data class LlmExtractionSampleDataItem(
    @property:LLMDescription("物料 ID,直接使用模板中的物料 ID。")
    val materialId: Long,
    @property:LLMDescription("质量特性 ID,直接使用模板中的质量特性 ID。")
    val characteristicId: Long,
    @property:LLMDescription("采样时间,必须为 ISO 8601 时间字符串。")
    val sampleTime: String,
    @property:LLMDescription("计量型采样值。")
    val variableValue: Double? = null,
    @property:LLMDescription("样本信息列表。")
    val metadata: List<LlmExtractionMetadataValueItem> = emptyList(),
)
8. 暂存区:替换页级结果并自动提交有效数据
大模型返回结果后,不是简单追加,而是“按页替换”。这避免用户多次点击提取后出现重复暂存数据。
// PdfExtractionPersistenceService.kt
fun replaceStagingSampleData(
    documentId: Long,
    pageIndex: Int,
    sampleDataList: List<IntelligentExtractionSampleDataItem>,
    creatorId: Long,
) {
    val page = requirePage(documentId, pageIndex)
    stagingSampleDataService.replacePageData(
        documentId = documentId,
        pageId = page.id,
        pageIndex = pageIndex,
        sampleDataList = sampleDataList,
        creatorId = creatorId,
    )
    sampleDataCommitService.commitExtractedSampleDataPage(documentId, pageIndex, creatorId)
    markPageDataExtractionStatus(documentId, pageIndex, PdfPageDataExtractionStatus.EXTRACTED)
}
暂存服务本身只做薄封装,真正的删除旧数据、写入新数据由仓储层完成。
// StagingSampleDataService.kt
@Service
class StagingSampleDataService(
    private val stagingSampleDataRepository: StagingSampleDataRepository,
) {
    fun replacePageData(
        documentId: Long,
        pageId: Long,
        pageIndex: Int,
        sampleDataList: List<IntelligentExtractionSampleDataItem>,
        creatorId: Long,
    ) {
        stagingSampleDataRepository.replacePageData(
            documentId = documentId,
            pageId = pageId,
            pageIndex = pageIndex,
            sampleDataList = sampleDataList,
            creatorId = creatorId,
        )
    }

    fun deletePageData(documentId: Long, pageIndex: Int) {
        stagingSampleDataRepository.deleteByDocumentIdAndPageIndex(documentId, pageIndex)
    }

    fun deleteDocumentData(documentId: Long) {
        stagingSampleDataRepository.deleteByDocumentId(documentId)
    }
}
这里目前还做了一个产品化选择:页级提取成功后会自动把有效检测值写入正式样本表,并将 PDF 文档标记为已入库。用户仍可以通过最终提交接口做全量提交校验。
9. 正式入库:校验、补充来源元数据、写入样本表
最终入库会检查所有页都已完成提取,并确保暂存数据不为空。入库前还会校验质量特性归属、数据类型和值域,防止 AI 输出结构被直接污染正式样本表。
// SampleDataCommitService.kt
@Transactional
fun commitStagingSampleData(
    documentId: Long,
    creatorId: Long,
) {
    val document =
        documentService.findDocumentById(documentId)
            ?: throw ResourceNotFoundException("error.pdf_extraction.document_not_found", arrayOf(documentId))

    if (!documentService.allPagesExtracted(documentId)) {
        throw InvalidRequestException("error.pdf_extraction.pages_not_all_extracted")
    }

    val stagingRows = stagingSampleDataRepository.listRecordsByDocumentId(documentId)
    if (stagingRows.isEmpty()) {
        throw ApplicationException("error.pdf_extraction.no_staging_sample_data", httpStatus = HttpStatus.UNPROCESSABLE_ENTITY)
    }

    stagingRows.forEach { validateStagingSampleData(it) }
    saveCommittedSampleData(document, stagingRows, creatorId)
    stagingSampleDataRepository.deleteByDocumentId(documentId)
    documentService.markCommitted(documentId)
}
页级自动提交只提交当前页有检测值的数据,空结果不会强行入库。
// SampleDataCommitService.kt
@Transactional
fun commitExtractedSampleDataPage(
    documentId: Long,
    pageIndex: Int,
    creatorId: Long,
) {
    val document =
        documentService.findDocumentById(documentId)
            ?: throw ResourceNotFoundException("error.pdf_extraction.document_not_found", arrayOf(documentId))

    val committableRows =
        stagingSampleDataRepository
            .listRecordsByDocumentIdAndPageIndex(documentId, pageIndex)
            .filter { it.hasDetectionValue() }

    if (committableRows.isEmpty()) {
        return
    }

    committableRows.forEach { validateStagingSampleData(it) }
    saveCommittedSampleData(document, committableRows, creatorId)
    documentService.markCommitted(documentId)
}
正式入库前会把 PDF 来源信息写入样本元数据,包括 PDF文件名 和 PDF页码。这让后续控制图方案可以按 PDF 文件名追溯数据来源。
// SampleDataCommitService.kt
private fun enrichCommittedMetadata(
    metadata: Map<String, String>,
    pdfFileName: String,
    pageIndex: Int,
): Map<String, String> =
    metadata.toMutableMap().apply {
        put(PDF_FILE_NAME_METADATA_KEY, pdfFileName)
        put(PDF_PAGE_INDEX_METADATA_KEY, pageIndex.toString())
    }
写入正式样本表时,计量值、计数值和元数据会被原样保存到 sample_data。
// CommittedSampleDataRepository.kt
@Repository
class CommittedSampleDataRepository {
    fun saveAll(
        rows: List<StagingSampleDataRecord>,
        creatorId: Long,
    ) {
        rows.forEach { staging ->
            SampleDataEntity.new {
                materialId = EntityID(staging.materialId, MaterialTable)
                characteristicId = EntityID(staging.characteristicId, CharacteristicTable)
                sampleTime = staging.sampleTime
                variableValue = staging.variableValue
                attributeValue = staging.attributeValue
                metadata = staging.metadata
                creator = UserEntity[creatorId]
            }
        }
    }
}
10. 状态汇总:页面级进度让前端可轮询
由于 OCR 和大模型提取都是异步任务,前端需要知道每一页处于什么状态。后端提供了文档级汇总和页级列表,方便前端轮询刷新。
// PdfExtractionService.kt
fun getPageDataExtractionStatusSummary(documentId: Long): PdfPageDataExtractionStatusSummaryResult {
    val document = requireDocumentById(documentId)
    val pages = documentService.findPagesByDocumentId(documentId)
    val stagingCounts = stagingSampleDataService.countGroupedByPageIndex(documentId)
    val statusItems =
        pages.map { page ->
            PdfPageDataExtractionStatusItemResult(
                pageIndex = page.pageIndex,
                status = page.status,
                stagingCount = stagingCounts[page.pageIndex] ?: 0,
                updatedAt = page.updatedAt,
            )
        }

    return PdfPageDataExtractionStatusSummaryResult(
        documentId = documentId,
        documentStatus = document.status,
        pageCount = pages.size,
        extractedPageCount = statusItems.count { it.status == PdfPageDataExtractionStatus.EXTRACTED },
        runningPageCount = statusItems.count { it.status == PdfPageDataExtractionStatus.RUNNING },
        failedPageCount = statusItems.count { it.status == PdfPageDataExtractionStatus.FAILED },
        pages = statusItems,
    )
}
状态枚举分成文档状态和页级提取状态。文档状态描述 OCR 与整体入库阶段,页级状态描述结构化提取阶段。
// PdfExtractionDocument.kt
enum class PdfExtractionStatus {
    UPLOADED,
    PENDING_REVIEW,
    REVIEWED,
    COMMITTED,
    OCR_FAILED,
}

enum class PdfPageDataExtractionStatus {
    NONE,
    RUNNING,
    EXTRACTED,
    FAILED,
    COMMITTED,
}
11. PDF 与控制图方案关联:按模板特性和 PDF 文件名匹配
PDF 入库后,样本数据会携带 PDF文件名 元数据。后端提供接口根据 PDF 文档反查控制图方案,逻辑是:
PDF 文档绑定模板。
模板绑定质量特性。
控制图方案也绑定质量特性。
在同一质量特性下,取 metadata 中
PDF文件名与 PDF 文件名相同的方案。
// PdfExtractionService.kt
@Transactional(readOnly = true)
fun findMatchedControlPlan(documentId: Long): ControlPlanListItem {
    val document = requireDocumentById(documentId)
    val templateId =
        document.templateId
            ?: throw ResourceNotFoundException("error.pdf_extraction.control_plan_template_unbound", arrayOf(documentId))
    val template = templateService.requireById(templateId)

    return controlPlanService
        .findFirstByCharacteristicIdAndPdfFileName(
            characteristicId = template.characteristicId,
            pdfFileName = document.fileName,
        )
        ?: throw ResourceNotFoundException(
            "error.pdf_extraction.control_plan_not_found",
            arrayOf<Any?>(documentId, document.fileName),
        )
}
// ControlPlanService.kt
fun findFirstByCharacteristicIdAndPdfFileName(
    characteristicId: Long,
    pdfFileName: String,
): ControlPlanListItem? {
    val normalizedPdfFileName = pdfFileName.trim()
    if (normalizedPdfFileName.isBlank()) {
        return null
    }

    return ControlPlanTable
        .join(MaterialTable, JoinType.INNER, onColumn = ControlPlanTable.materialId, otherColumn = MaterialTable.id)
        .join(CharacteristicTable, JoinType.INNER, onColumn = ControlPlanTable.characteristicId, otherColumn = CharacteristicTable.id)
        .join(UserTable, JoinType.INNER, onColumn = ControlPlanTable.creatorId, otherColumn = UserTable.id)
        .selectAll()
        .where { ControlPlanTable.characteristicId eq characteristicId }
        .orderBy(ControlPlanTable.updatedAt to SortOrder.DESC, ControlPlanTable.id to SortOrder.DESC)
        .firstOrNull { row ->
            row[ControlPlanTable.metadata][PDF_FILE_NAME_METADATA_KEY]?.trim() == normalizedPdfFileName
        }?.toControlPlanListItem()
}
这个关联方式避免了在 PDF 文档表上直接保存控制图方案 ID,也保留了“一个特性下多个 PDF 来源方案”的灵活性。