本文以天禄 SPC 智能问答助手为例,说明一条完整的全栈问答链路:后端使用 FastAPI、LangChain、LangGraph 和阿里云百炼 OpenAI 兼容接口,前端使用 TDesign Chat for Vue,前后端通过 AG-UI SSE 传递结构化事件。
文章分为两部分:先还原当前项目的真实实现,再抽象出更适合生产系统的推荐架构,并穿插实际遇到的错误和排查过程。
业务背景:让天禄 SPC 支持 IQC 数据智能分析
天禄 SPC 系统沉淀了大量 IQC(来料质量检验)数据,包括供应商、报表、检测项目、检验批次、CPK、不合格点、不稳定点、合格率和异常率等质量指标。
为了降低 IQC 数据分析的使用门槛,项目在天禄 SPC 现有报表和指标能力之上增加自然语言问答入口,让用户可以直接询问:
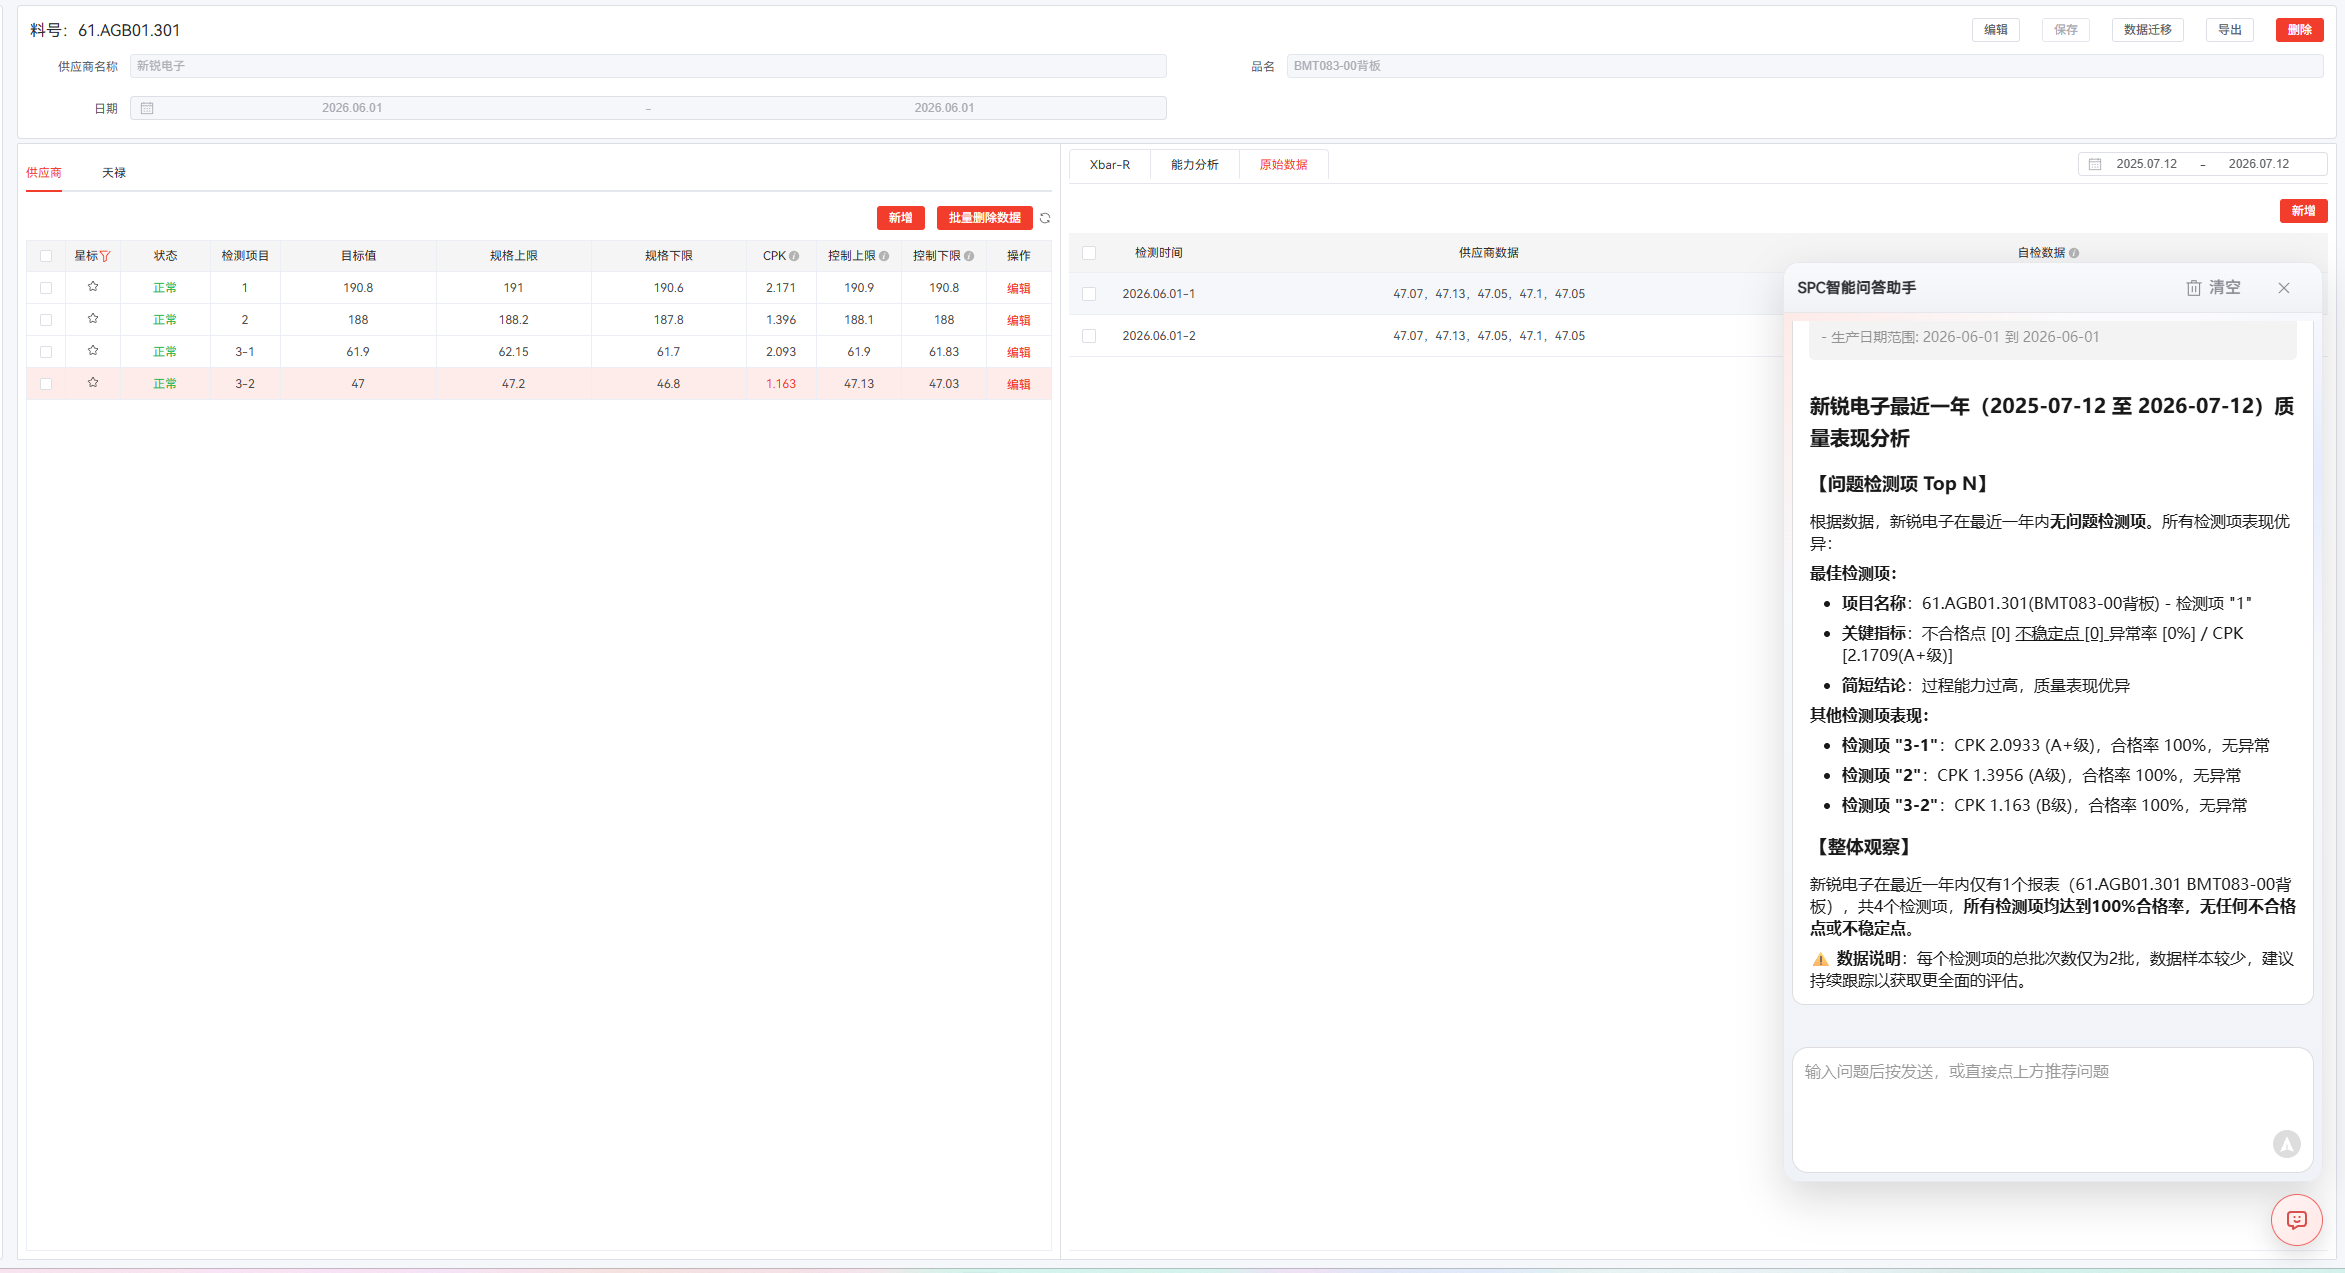
新锐最近半年表现如何?
系统会自动识别供应商和时间范围,调用 IQC 业务工具查询报表及质量指标,再由模型根据真实数据生成分析结论。Agent 和工具负责完成数据查询,模型负责理解问题和组织回答,避免凭空生成供应商或质量结论。
一、技术栈与版本
本文示例基于项目当前锁定版本。依赖升级后,LangChain 事件结构和 TDesign Chat 的事件支持都可能发生变化。
模型服务商使用阿里云百炼 OpenAI 兼容 Responses API:
LLM_BASE_URL=https://dashscope.aliyuncs.com/compatible-mode/v1
LLM_MODEL=qwen3.7-plus
LLM_USE_RESPONSES_API=true
LLM_OUTPUT_VERSION=responses/v1
LLM_ENABLE_THINKING=true
LLM_TIMEOUT_SECONDS=60
这里的“推理内容”需要准确理解为模型服务商返回的 reasoning summary,而不是模型完整、未经处理的隐藏思维链。产品上更适合称为“推理摘要”或“思考摘要”。
二、先把问题说清楚
一个最简单的问答流程是:
用户问题 -> 模型 -> 文本答案
一旦加入 Agent 和工具,流程就变成:
用户问题
  -> 模型分析
  -> 模型决定调用工具
  -> 工具查询业务数据
  -> 模型根据工具结果继续分析
  -> 模型生成最终答案
这时后端需要同时处理三种不同性质的信息:
模型推理摘要:解释模型当前在做什么。
工具调用信息:说明调用了哪个内部查询工具。
最终回答:真正展示给用户的业务结论。
如果把三者都当成普通文本发送,前端就会出现几个典型问题:
工具返回的 JSON 直接显示在聊天正文中。
中间节点的文本被误认为最终答案。
思考摘要和最终答案重复出现。
前端收到
RUN_ERROR,但后端日志看不出是哪个事件结构解析失败。
核心问题不是如何把所有返回内容都转发出去,而是先为不同内容建立稳定的归属边界。
三、整体架构
3.1 当前实现
当前项目的后端链路如下:
flowchart LR
    A[用户输入] --> B[TDesign Chat for Vue]
    B -->|POST + SSE| C[FastAPI /agent-chat/stream]
    C --> D[消息归一化]
    D --> E[LangGraph Agent]
    E --> F[ChatOpenAI]
    E --> G[业务工具]
    F --> H[astream_events]
    G --> H
    H --> I[事件路由]
    I --> J[推理摘要]
    I --> K[工具摘要]
    I --> L[最终正文]
    J --> M[AG-UI SSE]
    K --> M
    L --> M
    M --> B
后端的关键职责可以拆成四层:
前端不需要理解 Command、AIMessage 或 LangGraph state,只消费 AG-UI 事件。
当前项目通过 LangChain 的 create_agent 创建 Agent。LangChain 官方 Agent 文档说明,create_agent 会在底层构建基于 LangGraph 的 Agent 运行时,因此这里使用 LangGraph 是 Agent 编排实现的一部分,而不是前端协议的一部分。
3.2 推荐架构
当前代码已经能够工作,但事件路由仍然依赖当前 LangGraph 的名称,例如 model 和 LangGraph。更适合生产系统的架构应该在 provider 边界增加一层内部事件适配器:
flowchart LR
    A[Provider 原始事件] --> B[Provider Adapter]
    B --> C[内部统一事件]
    C --> D[Reasoning Mapper]
    C --> E[Tool Mapper]
    C --> F[Answer Mapper]
    D --> G[AG-UI Encoder]
    E --> G
    F --> G
    G --> H[前端 SSE]
这样做的收益是:
LangGraph 节点名称变化不会扩散到前端和业务层。
更换模型供应商时,只改 provider adapter。
模型流式增量和图状态聚合不会混在同一个处理函数中。
事件解析失败可以在边界层快速暴露,而不是在正文渲染阶段报错。
四、后端如何调用模型
4.1 模型配置
当前模型通过 ChatOpenAI 的 OpenAI 兼容能力连接阿里云百炼:
ChatOpenAI(
    api_key=settings.LLM_API_KEY,
    base_url=settings.LLM_BASE_URL,
    model=settings.LLM_MODEL,
    timeout=settings.LLM_TIMEOUT_SECONDS,
    use_responses_api=settings.LLM_USE_RESPONSES_API,
    output_version=settings.LLM_OUTPUT_VERSION,
    extra_body={"enable_thinking": settings.LLM_ENABLE_THINKING},
)
几个配置的职责如下:
当前代码通过 extra_body 传递 enable_thinking,并已从实际日志中确认拿到了 reasoning block。需要注意的是,阿里云百炼的 Responses API 文档目前建议优先使用 reasoning.effort,并提示 enable_thinking 后续可能不再支持;因此这段配置属于当前项目与兼容接口的实现方式,不应当当作长期稳定的 OpenAI 标准参数。本文的事件结构来自当前阿里云百炼 Qwen 兼容接口的实际返回。
4.2 请求消息归一化
前端只发送一个明确的 messages 字段:
{
  "messages": [
    {"role": "user", "content": "SPC 是什么?"}
  ]
}
后端再把前端消息转换成 LangChain 消息对象:
system    -> SystemMessage
user      -> HumanMessage
assistant -> AIMessage
业务系统提示词由后端统一补充,前端不负责拼接系统约束。前后端协议只保留 messages,TDesign Chat 的 prompt 只用于组件内部触发发送,发送给后端时转换成最后一条 user message。
五、为什么使用 astream_events()
LangChain 常见的两种流式接口关注点不同:
智能问答同时需要模型推理、工具开始、工具结束和最终答案,所以当前使用 LangChain 的事件流接口:
async for event in client.astream_events(messages=normalized_messages):
    ...
LLMQAService 调用的是项目自己的 AgentClient 包装器,AgentClient 内部实际调用如下:
async for event in self._agent.astream_events(
    {"messages": messages},
    version="v2",
):
    yield event
当前项目实际使用 v2。LangChain 官方文档正在推进带类型投影的新版 Event Streaming API,并介绍了 v3 事件流,因此本文下面的原始事件结构只适用于当前项目锁定的 LangChain/LangGraph 版本和 v2 调用方式,不代表所有版本的统一返回结构。
astream_events() 返回的不是单一消息,而是一串带有来源和负载的事件。可以参考 LangChain 官方 Streaming 文档 和 Event Streaming 文档。最重要的字段是:
六、真实事件结构
6.1 模型节点的流式事件
当前真实日志中,模型节点的 on_chain_stream 结构类似:
{
    "event": "on_chain_stream",
    "name": "model",
    "data": {
        "chunk": [
            Command(
                update={
                    "messages": [
                        AIMessage(
                            content=[
                                {"type": "reasoning", "summary": [...]},
                                {"type": "text", "text": "..."},
                            ]
                        )
                    ]
                }
            )
        ]
    }
}
取值路径是:
data["chunk"][-1]
  -> Command.update
  -> ["messages"][-1]
  -> AIMessage.content
这里的 Command 不是 AIMessage,所以不能直接读取 chunk[-1].content,必须先进入 Command.update["messages"]。
6.2 LangGraph 聚合事件
LangGraph 还会发出图状态聚合事件:
{
    "event": "on_chain_stream",
    "name": "LangGraph",
    "data": {
        "chunk": {
            "model": {
                "messages": [AIMessage(...)]
            }
        }
    }
}
这不是消息对象,而是图状态更新。当前实现直接忽略它:
if event_name == "on_chain_stream" and event["name"] == "model":
    return handle_chain_stream(event=event, state=state)
这条判断避免了两类问题:把 Command 当成 AIMessage 导致 Command.content 异常,以及把 LangGraph 聚合字典当成完整 state 导致 'messages' 异常。
6.3 最终 LangGraph 输出
最终 on_chain_end 且 name == "LangGraph" 时,负载才是完整 state:
{
    "event": "on_chain_end",
    "name": "LangGraph",
    "data": {
        "output": {
            "messages": [
                SystemMessage(...),
                HumanMessage(...),
                AIMessage(...),
            ]
        }
    }
}
后端只取最终消息:
message = event["data"]["output"]["messages"][-1]
最终消息的 content 同时可能包含推理摘要和正文 block,但两者必须分开提取:
[
    {
        "type": "reasoning",
        "summary": [{"type": "summary_text", "text": "..."}],
    },
    {"type": "text", "text": "最终答案"},
]
6.4 三类事件分别对应什么消息
第 6.1 到 6.3 节描述的都是后端收到的 LangChain/LangGraph 原始事件,不是前端最终看到的三条普通聊天消息。它们的对应关系如下:
可以把它们理解成三个不同阶段:
6.1 模型节点输出       -> 模型正在生成什么
6.2 图状态聚合          -> LangGraph 内部状态发生了什么
6.3 图执行最终输出      -> 本轮 Agent 最终要给用户什么
其中只有 6.1 和 6.3 包含真正的 AIMessage。6.2 是 LangGraph 的状态包装,不是用户消息,也不应该转换成 TEXT_MESSAGE_CONTENT。当前设计把 6.1 的推理摘要作为实时过程,把 6.3 的 text block 作为最终答案,因此中间状态不会泄漏到正文区域。
七、从 LangChain 事件映射到 AG-UI
7.1 三条输出通道
后端把输出严格分成三条通道:
7.2 事件映射表
7.3 AG-UI 运行顺序
一轮正常请求的 AG-UI 事件大致如下:
RUN_STARTED
REASONING_START
REASONING_MESSAGE_START
REASONING_MESSAGE_CONTENT ...
TOOL_CALL_START
TOOL_CALL_ARGS
REASONING_MESSAGE_CONTENT ...
TOOL_CALL_RESULT
TOOL_CALL_END
REASONING_MESSAGE_CONTENT ...
TEXT_MESSAGE_START
TEXT_MESSAGE_CONTENT ...
REASONING_MESSAGE_END
REASONING_END
TEXT_MESSAGE_END
RUN_FINISHED
如果模型没有调用工具,就会跳过工具事件。工具调用只是后端内部的数据查询动作,不要求前端展示完整工具输入或输出。当前后端仍会发送 AG-UI 的 ToolCall 生命周期事件,但只发送工具名称和极简固定摘要;前端可以不单独渲染这些事件,而通过 reasoning 摘要展示过程。工具原始 JSON 不进入 TEXT_MESSAGE_CONTENT。
八、前端如何接收 SSE
8.1 TDesign Chat for Vue
前端通过 Chatbot 组件和 ChatServiceConfig 接入后端:
const chatServiceConfig: ChatServiceConfig = {
  endpoint: '/api/agent-chat/stream',
  protocol: 'agui',
  stream: true,
  onRequest: (params) => ({
    method: 'POST',
    headers: {
      Accept: 'text/event-stream',
      'Content-Type': 'application/json'
    },
    body: JSON.stringify({
      messages: params.prompt
        ? [{ role: 'user', content: params.prompt }]
        : []
    })
  })
}
关键配置是:
protocol: 'agui':让聊天引擎按 AG-UI 协议解析。stream: true:以流式方式接收 SSE。Accept: text/event-stream:告诉后端需要 SSE 响应。messages:前后端统一的请求字段。
8.2 AG-UI 与 TDesign 的兼容处理
根据 AG-UI 官方事件定义,THINKING_* 已被标记为废弃事件,推荐使用 REASONING_*。当前项目使用的 TDesign Chat for Vue 0.5.2 接入层仍按 THINKING_* 类型消费,因此项目增加了以下兼容转换:
因此前端增加了一层兼容转换:
REASONING_START                  -> THINKING_START
REASONING_MESSAGE_START         -> THINKING_MESSAGE_START
REASONING_MESSAGE_CONTENT       -> THINKING_MESSAGE_CONTENT
REASONING_MESSAGE_END           -> THINKING_MESSAGE_END
REASONING_END                   -> THINKING_END
转换只发生在前端展示适配层,后端仍然发送标准 AG-UI reasoning 事件。将来 TDesign 完成协议升级后,只需移除适配层。
8.3 为什么最终正文不能走 reasoning
TDesign 会把 reasoning/thinking 内容渲染到思考区域,把 text 内容渲染到正常回答区域。如果后端把中间 JSON、工具结果或模型草稿发送成 TEXT_MESSAGE_CONTENT,前端无法再判断它们是不是最终答案。
因此职责必须在后端完成:
reasoning block -> REASONING_MESSAGE_CONTENT -> 思考区域
text block      -> TEXT_MESSAGE_CONTENT      -> 正文区域
九、工具调用如何处理
9.1 后端工具调用
工具由 Agent 后端执行,用于查询供应商、报表、时间范围和 SPC 指标。工具不是前端调用的 API,也不需要前端知道数据库结构。
工具 start 事件中,后端使用:
run_id -> toolCallId
name   -> toolCallName
工具 end 事件通过同一个 run_id 关联 start 和 end。
9.2 为什么不把工具原始结果发给前端
工具返回通常是结构化 JSON,例如供应商列表、日期范围和指标数组。原样发送会让思考区域变成一大段不可读的内部数据,也可能被误认为最终回答。
当前设计不会把原始工具数据发送给前端;后端会发送 ToolCall 协议事件,同时在 reasoning 中发送:
调用工具 resolve_suppliers。
工具 resolve_suppliers 已返回结果。
真正的工具数据继续留在后端,交给后续模型节点生成最终答案。是否单独显示 ToolCall 事件由前端聊天引擎的解析和展示配置决定,不能把“协议事件已发送”和“界面是否展示”混为一谈。
9.3 当前实现与推荐实现
当前实现使用固定摘要,简单可靠:
emit_reasoning_delta(state, f"调用工具 {tool_name}。\n")
emit_reasoning_delta(state, f"工具 {tool_name} 已返回结果。\n")
如果未来需要更有信息量的过程展示,可以在后端增加业务摘要器,但摘要器必须输出有限长度、面向用户的文本,而不是直接 json.dumps(tool_output)。
十、真实排错案例
10.1 Command 没有 content
错误:
大模型调用异常: 'Command' object has no attribute 'content'
原因:
on_chain_stream.data.chunk[-1] 是 Command
Command.update["messages"][-1] 才是 AIMessage
错误代码通常类似:
message = event["data"]["chunk"][-1]
message.content
修复:先按照当前事件契约进入 Command.update["messages"],再读取 AIMessage.content。
10.2 'messages' 不存在
错误:
大模型调用异常: 'messages'
原因是把 LangGraph 聚合事件当成了完整 state:
data["chunk"] == {"model": {"messages": [...]}}
而不是:
data["chunk"] == {"messages": [...]}
修复方法不是在提取器里继续添加多层 fallback,而是先按事件来源分流:
if event_name == "on_chain_stream" and event["name"] == "model":
    ...
10.3 中间文本泄漏到正文
现象:前端思考区域之外出现了工具返回 JSON、时间解析结果或供应商列表。
原因:中间 on_chain_stream 或工具结果被错误转换成了 TEXT_MESSAGE_CONTENT。
修复原则:
on_chain_stream只提取 reasoning。工具结果只生成 reasoning 摘要。
只有
on_chain_end且name == "LangGraph"的最终 state 才允许生成正文。
10.4 最后出现 RUN_ERROR
现象:前端已经收到 reasoning 和 text,最后又收到:
{"type":"RUN_ERROR","message":"大模型调用异常: ..."}
这通常说明流式事件中途或收尾阶段仍有一个未处理事件抛出异常。路由层会捕获异常并编码成 RUN_ERROR,所以排查时不能只看前面已经成功显示的内容。
排查顺序应是:
记录发生异常前最后一个原始 LangChain 事件。
查看
event、name和data的真实类型。确认该事件是否应该进入当前 mapper。
确认 reasoning、text 的 start/end 是否成对。
确认最终
LangGraph输出是否仍然包含messages。
10.5 为什么不在每一层增加兜底
大量这样的代码看起来安全:
if isinstance(value, dict):
    ...
elif isinstance(value, list):
    ...
elif hasattr(value, "messages"):
    ...
但它会掩盖真正的问题:调用方并不知道自己拿到的到底是什么。更好的做法是:
在 provider 边界确认事件契约。
为不同事件来源使用不同提取函数。
对不属于当前处理范围的事件直接忽略。
只对真正不可控的外部输入保留必要保护。
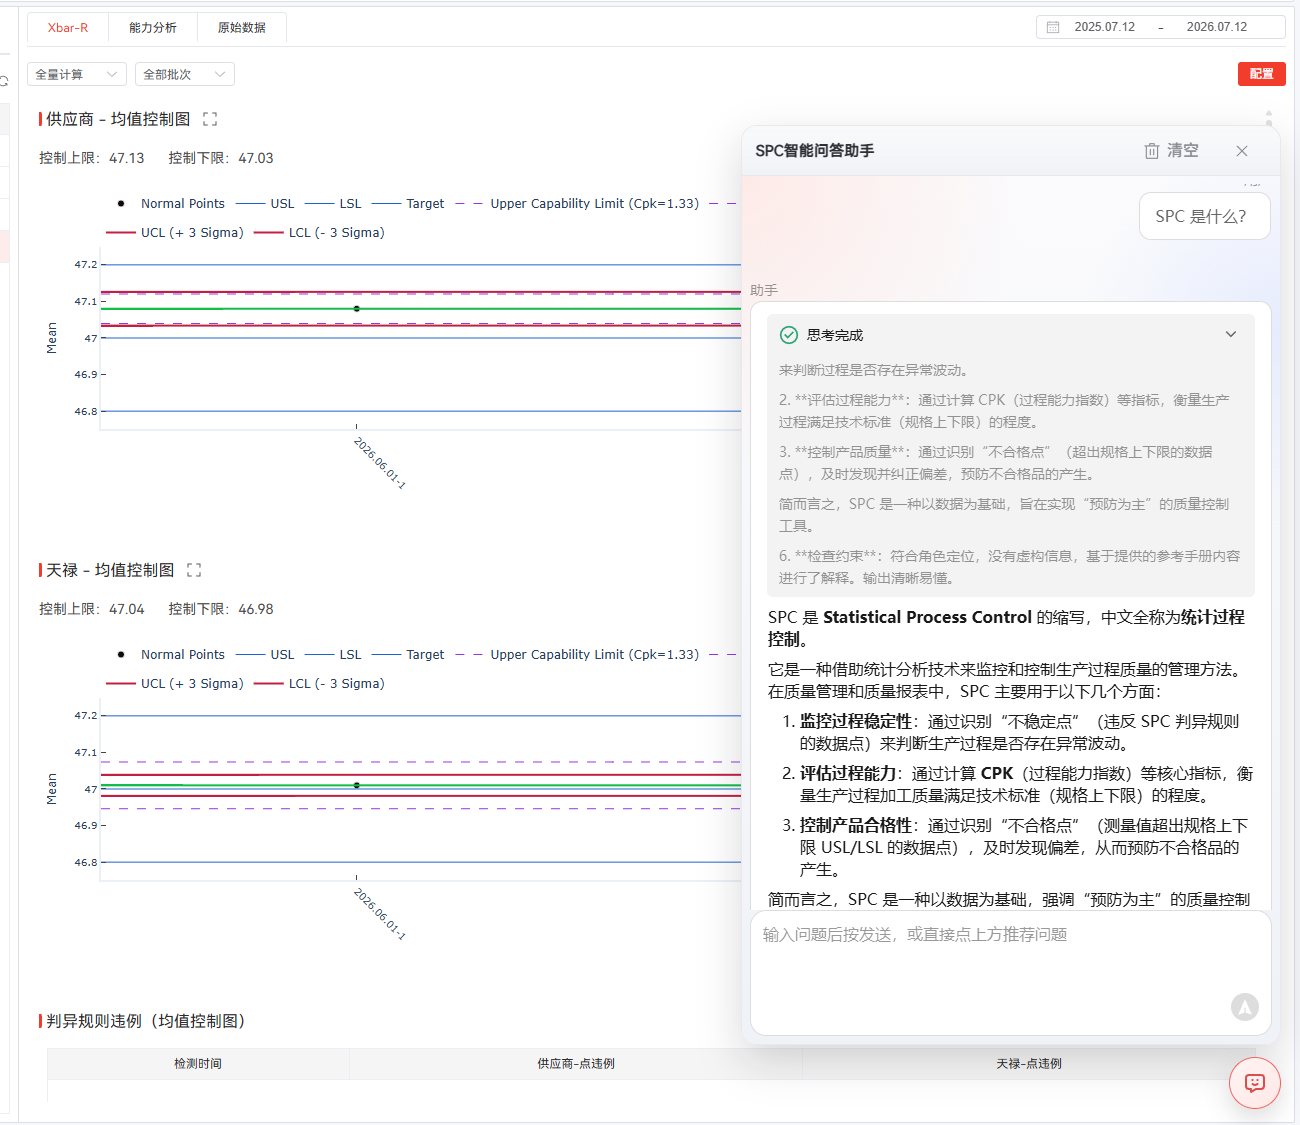
十一、结果展示
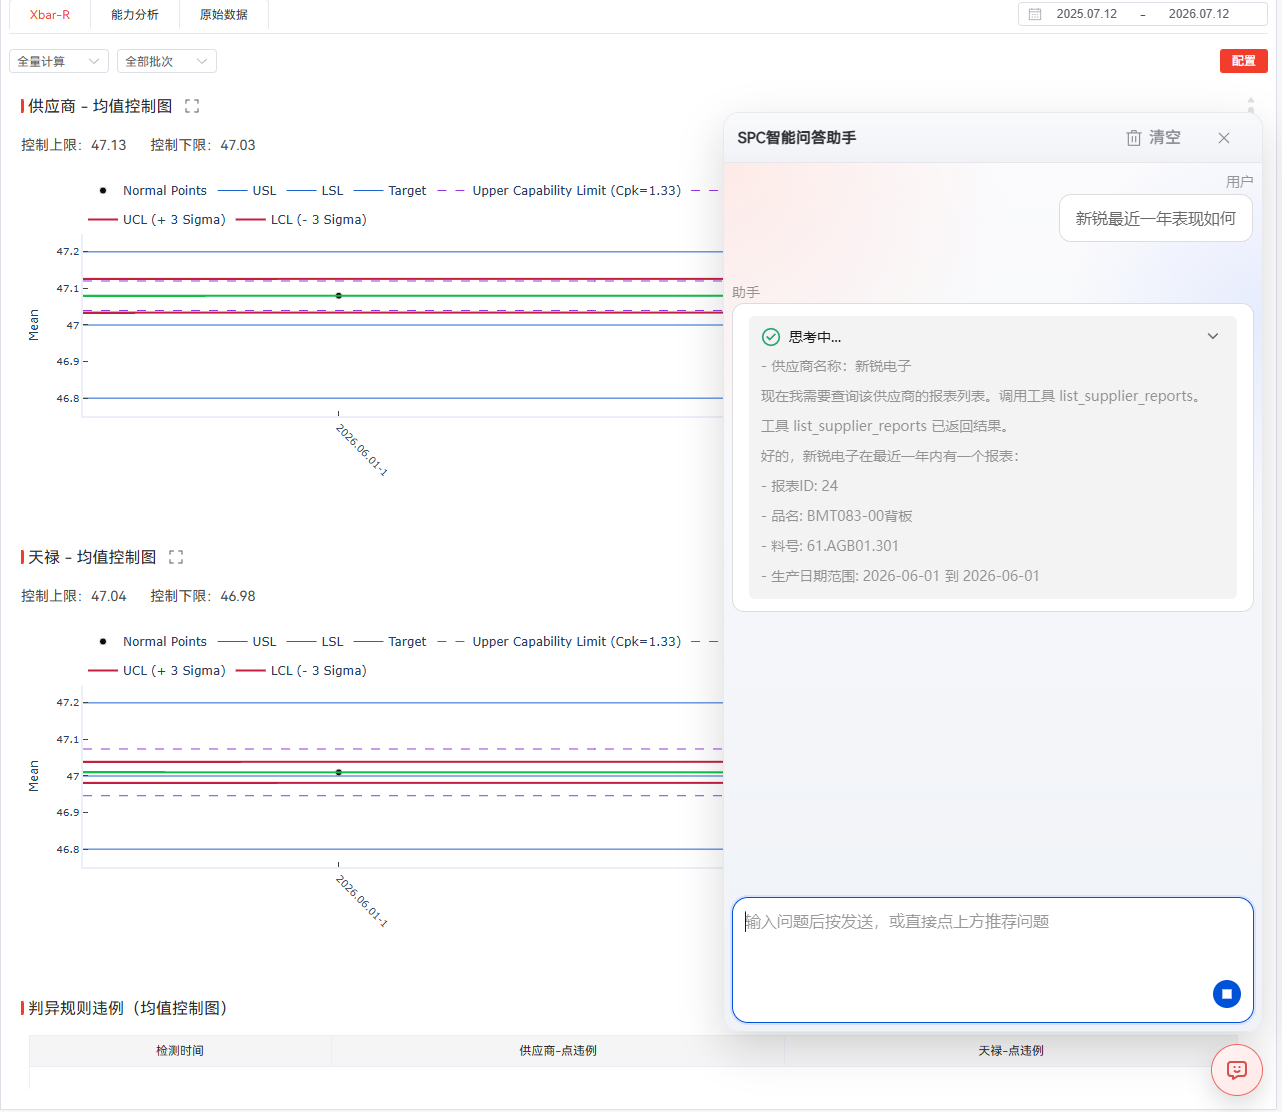
1.通用知识问答
2.指定业务数据提问